
Índice
- La respuesta en una frase
- Cómo se mide un modelo de texto a voz
- Qué dicen los benchmarks sobre Kokoro-82M
- Qué dicen los benchmarks sobre Supertonic 3
- La comparación directa que explica nuestra decisión
- Por qué Local TTS conecta los dos modelos
- Cómo leer estas cifras con honestidad
- Preguntas frecuentes
- Escucha los benchmarks por ti mismo
Local TTS incluye dos modelos neuronales de voz en lugar de uno. Kokoro-82M pone las voces de inglés estadounidense y británico, y Supertonic 3 pone la voz multilingüe que lee 31 idiomas. Ambos funcionan por completo en tu iPhone o iPad.
¿Por qué llevar dos modelos si con uno la aplicación sería más pequeña y sencilla? Porque los resultados publicados dan una respuesta clara: hoy ningún modelo compacto para el dispositivo gana a la vez en naturalidad, precisión de lectura, velocidad y cobertura de idiomas. Cada uno de estos dos gana una carrera distinta, y combinarlos permite a Local TTS usar cada modelo justo donde es más fuerte.
Este artículo repasa los resultados de evaluación oficiales que hay detrás de esa decisión: qué midieron los creadores de cada modelo, qué encontró una prueba independiente y cómo se traduce todo eso en el lector que realmente escuchas.
Fuentes e imagen de portada: La portada es el gráfico oficial de precisión de lectura de Supertone, reproducido sin cambios desde el repositorio de Supertonic. Las cifras de Kokoro proceden de la ficha oficial del modelo hexgrad/Kokoro-82M; las de Supertonic, del repositorio oficial de Supertone y de su ficha del modelo; la comparación directa en CPU, de un benchmark independiente de terceros. Quienes publicaron estas cifras las midieron en su propio hardware, no en un iPhone.
La respuesta en una frase
Kokoro-82M lidera las valoraciones humanas de naturalidad en inglés; Supertonic 3 lidera en velocidad sobre CPU y lee 31 idiomas con precisión competitiva. Por eso Local TTS envía el inglés a Kokoro y todo lo multilingüe a Supertonic 3, siempre en tu dispositivo.
Cómo se mide un modelo de texto a voz
Para una aplicación de lectura importan cuatro medidas, y conviene saber qué significa cada una antes de mirar los números:
- La naturalidad la juzgan personas. La prueba pública más conocida es una «arena» a ciegas: los oyentes escuchan dos clips anónimos y votan por el que suena más natural, lo que produce una clasificación tipo Elo en la que el marketing no puede influir.
- La precisión de lectura pregunta si el modelo dijo exactamente el texto que recibió, sin palabras saltadas, repetidas o confusas. Se puntúa como tasa de errores por palabra (WER) o por carácter (CER), transcribiendo de vuelta a texto el audio generado. Cuanto más baja, mejor.
- La velocidad se expresa como factor de tiempo real (RTF): el tiempo de síntesis dividido por la duración del audio. Un RTF de 0.3 significa que un segundo de voz tarda 0.3 segundos en generarse, es decir, unas 3.3 veces más rápido que el tiempo real. Cuanto más bajo, más rápido.
- El tamaño abarca los parámetros, la descarga y la memoria: la diferencia entre un modelo que cabe en una aplicación de móvil y uno que necesita una GPU de servidor.
Una voz en la nube puede perseguir las cuatro cosas con hardware de centro de datos. Un modelo en el dispositivo tiene que elegir, y ahí es donde estos dos modelos toman caminos distintos.
Qué dicen los benchmarks sobre Kokoro-82M
El resultado estrella de Kokoro-82M es una clasificación por preferencia humana. Antes de su versión 1.0, la ficha oficial del modelo recogía que Kokoro v0.19 quedó n.º 1 en TTS Spaces Arena, la arena de escucha a ciegas de Hugging Face, con un Elo superior al de modelos muchas veces mayores —incluidos XTTS v2 (467 millones de parámetros) y MetaVoice (1200 millones)— tras entrenarse con solo unos cientos de horas de audio.
Es un resultado poco habitual que merece una pausa. En una prueba donde los oyentes no veían nombres de modelos ni recuentos de parámetros, un modelo de 82 millones de parámetros fue el preferido frente a sistemas de miles de millones. En naturalidad inglesa por unidad de cálculo, Kokoro marcó el estándar de los modelos compactos.
| Kokoro-82M v1.0 | |
|---|---|
| Parámetros | 82 millones |
| Evaluación humana | v0.19, n.º 1 en TTS Spaces Arena |
| Salida | Voz a 24 kHz |
| Voces | 54 voces públicas; 28 voces inglesas en Local TTS |
| Licencia | Apache 2.0 |
| Función en Local TTS | Catálogo de inglés estadounidense y británico |
La contrapartida es la cobertura. La versión pública de Kokoro abarca ocho idiomas, pero su propio catálogo de voces advierte que la calidad fuera del inglés varía según los datos de entrenamiento. Es un especialista: excepcional en inglés, justo en el resto.
Qué dicen los benchmarks sobre Supertonic 3
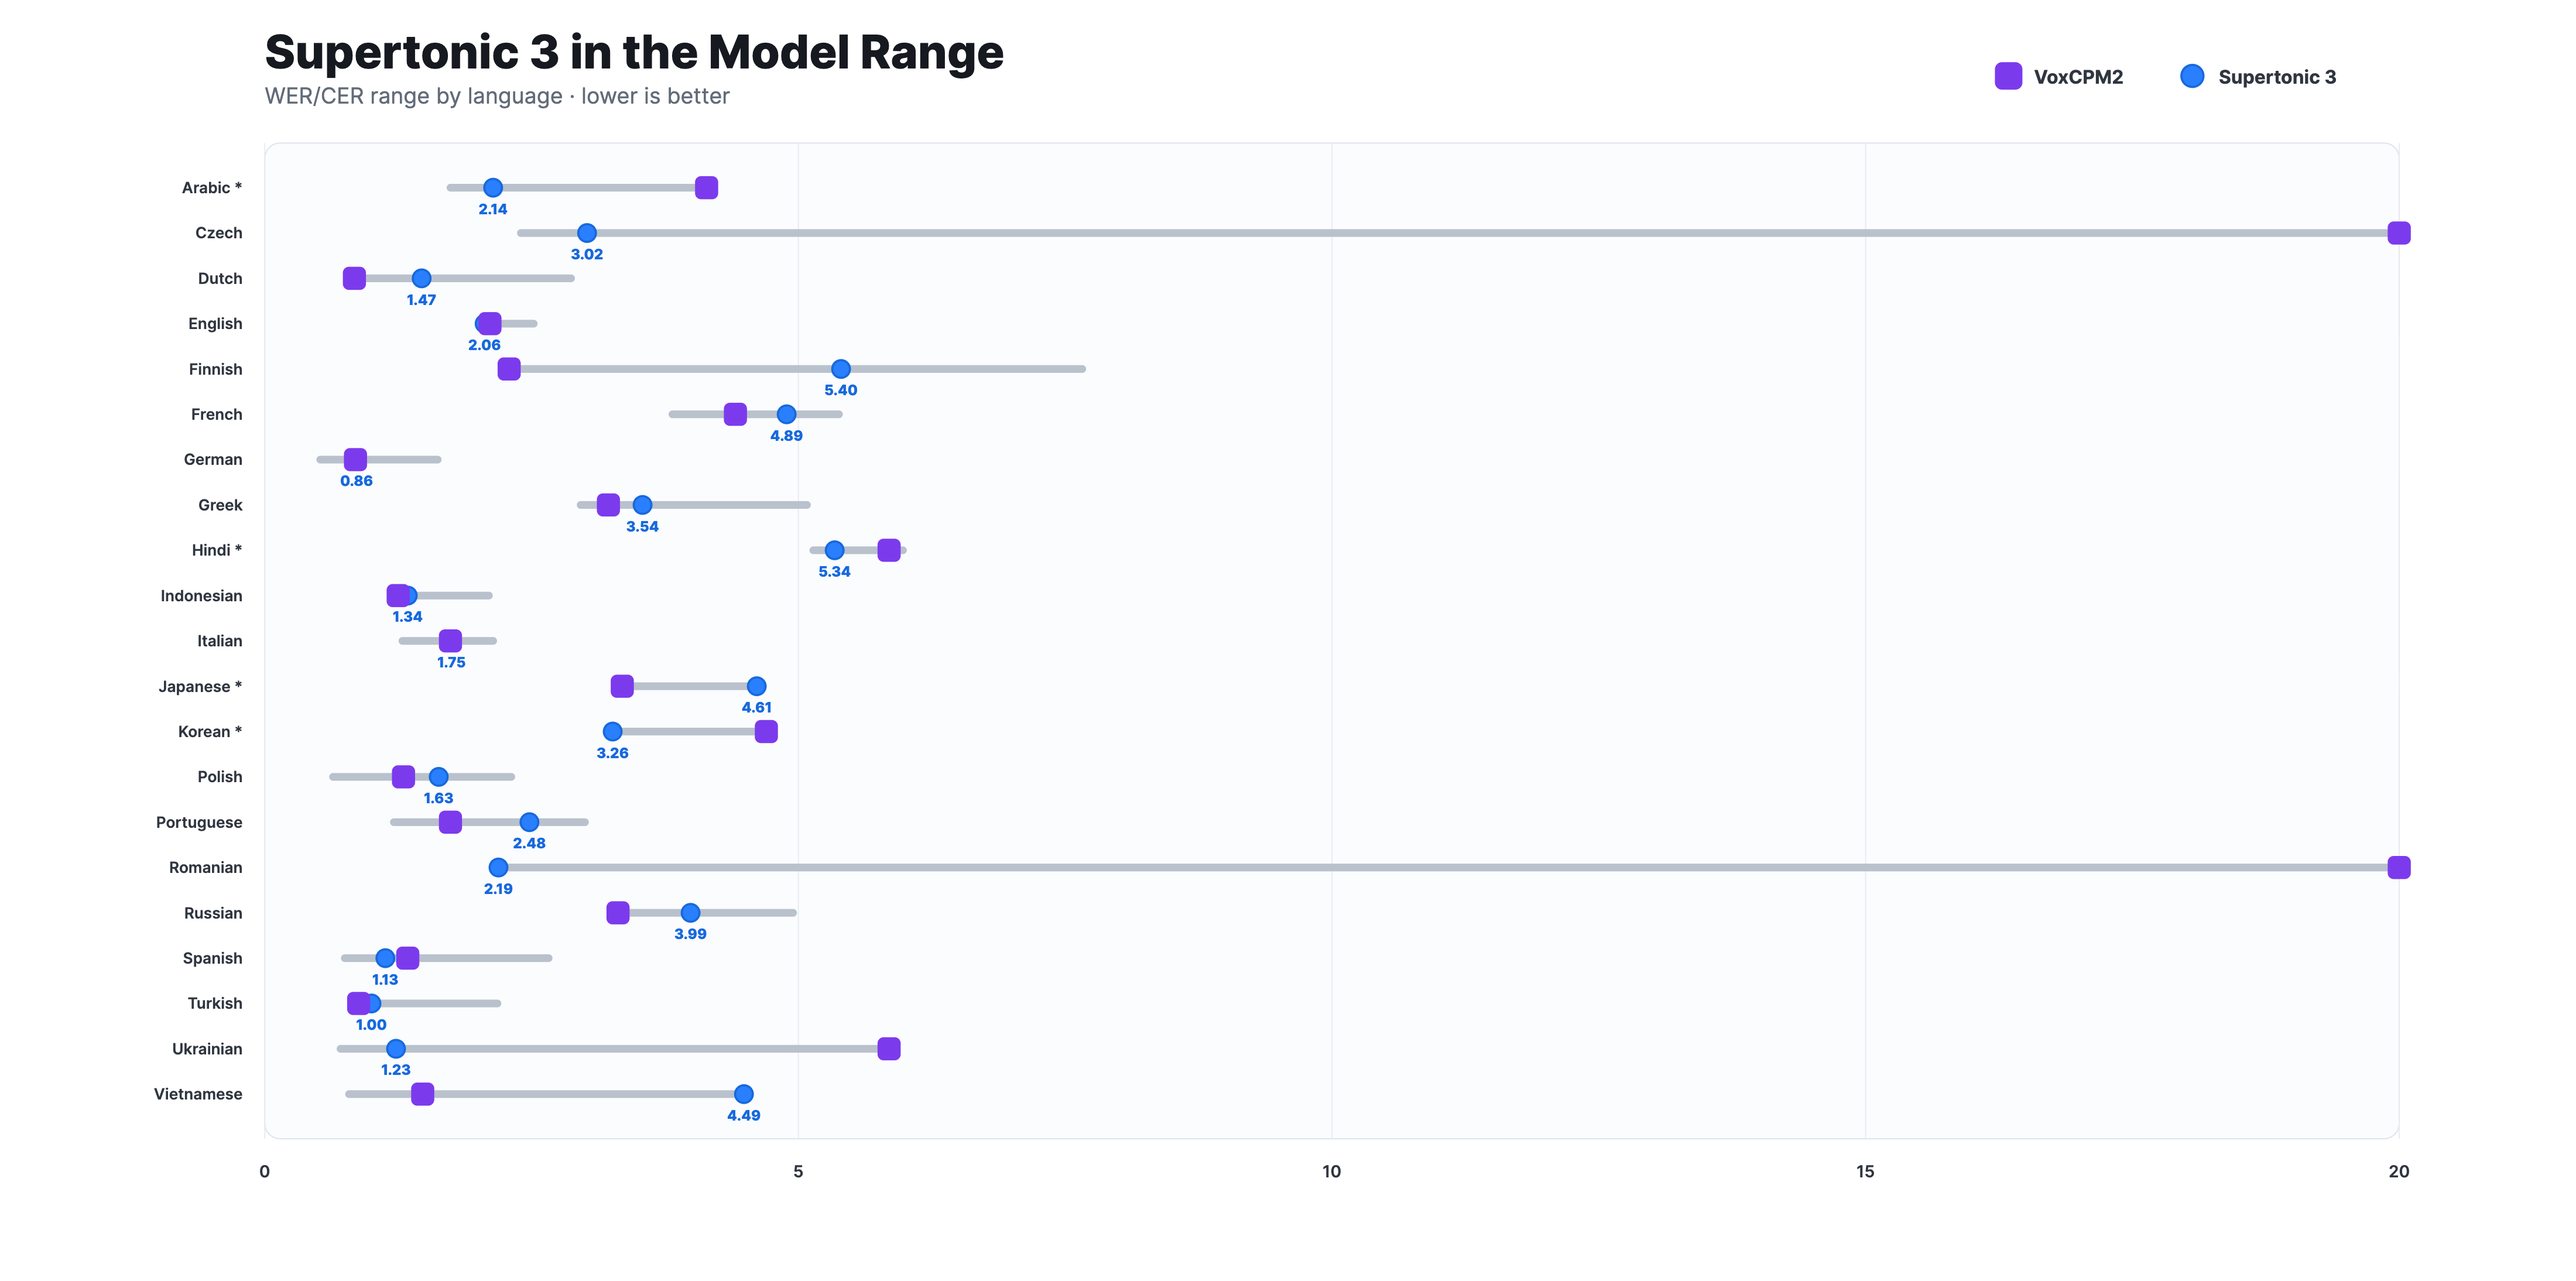
Supertonic 3, publicado por Supertone el 29 de abril de 2026, se evalúa en la dirección contraria: amplitud y eficiencia. El repositorio oficial publica resultados de precisión de lectura en el benchmark Minimax-MLS-test, comparando su modelo de unos 99 millones de parámetros con sistemas TTS abiertos mucho mayores, como VoxCPM2, OmniVoice y Qwen3-TTS.
Estas son las tasas de error publicadas por Supertone para los once idiomas en los que está escrito este sitio web (más bajo es mejor; * marca tasa de errores por carácter, el resto por palabra):
| Idioma | VoxCPM2 | OmniVoice | Qwen3-TTS | Supertonic 3 |
|---|---|---|---|---|
| Inglés | 2.11 | 2.02 | 2.25 | 2.06 |
| Coreano* | 4.70 | 3.22 | 4.07 | 3.26 |
| Japonés* | 3.35 | 3.81 | 3.67 | 4.61 |
| Alemán | 0.85 | 0.96 | 0.52 | 0.86 |
| Francés | 4.41 | 4.74 | 3.82 | 4.89 |
| Español | 1.34 | 0.99 | 0.75 | 1.13 |
| Portugués | 1.74 | 1.40 | 1.21 | 2.48 |
| Italiano | 1.74 | 1.29 | 1.40 | 1.75 |
| Neerlandés | 0.84 | 0.77 | — | 1.47 |
| Polaco | 1.30 | 0.64 | — | 1.63 |
| Turco | 0.88 | 2.18 | — | 1.00 |
Supertonic 3 no gana en todas las filas, y Supertone no afirma lo contrario. La conclusión oficial es más útil: se mantiene dentro del rango de error competitivo de modelos varias veces mayores, en 31 idiomas, y sigue siendo lo bastante pequeño para funcionar sin ninguna GPU.
Donde sus cifras destacan es en la velocidad. Supertone demuestra Supertonic 3 en hardware mucho más modesto que un iPhone actual: un lector electrónico Onyx Boox Go 6 en modo avión, con un RTF medio de 0.3× —unas tres veces más rápido que el tiempo real en un lector de tinta electrónica— y síntesis en tiempo real en una Raspberry Pi. Su comparación oficial de rendimiento lo muestra rápido en CPU corrientes incluso frente a modelos mayores medidos en una GPU de servidor NVIDIA A100, y con bastante menos memoria.
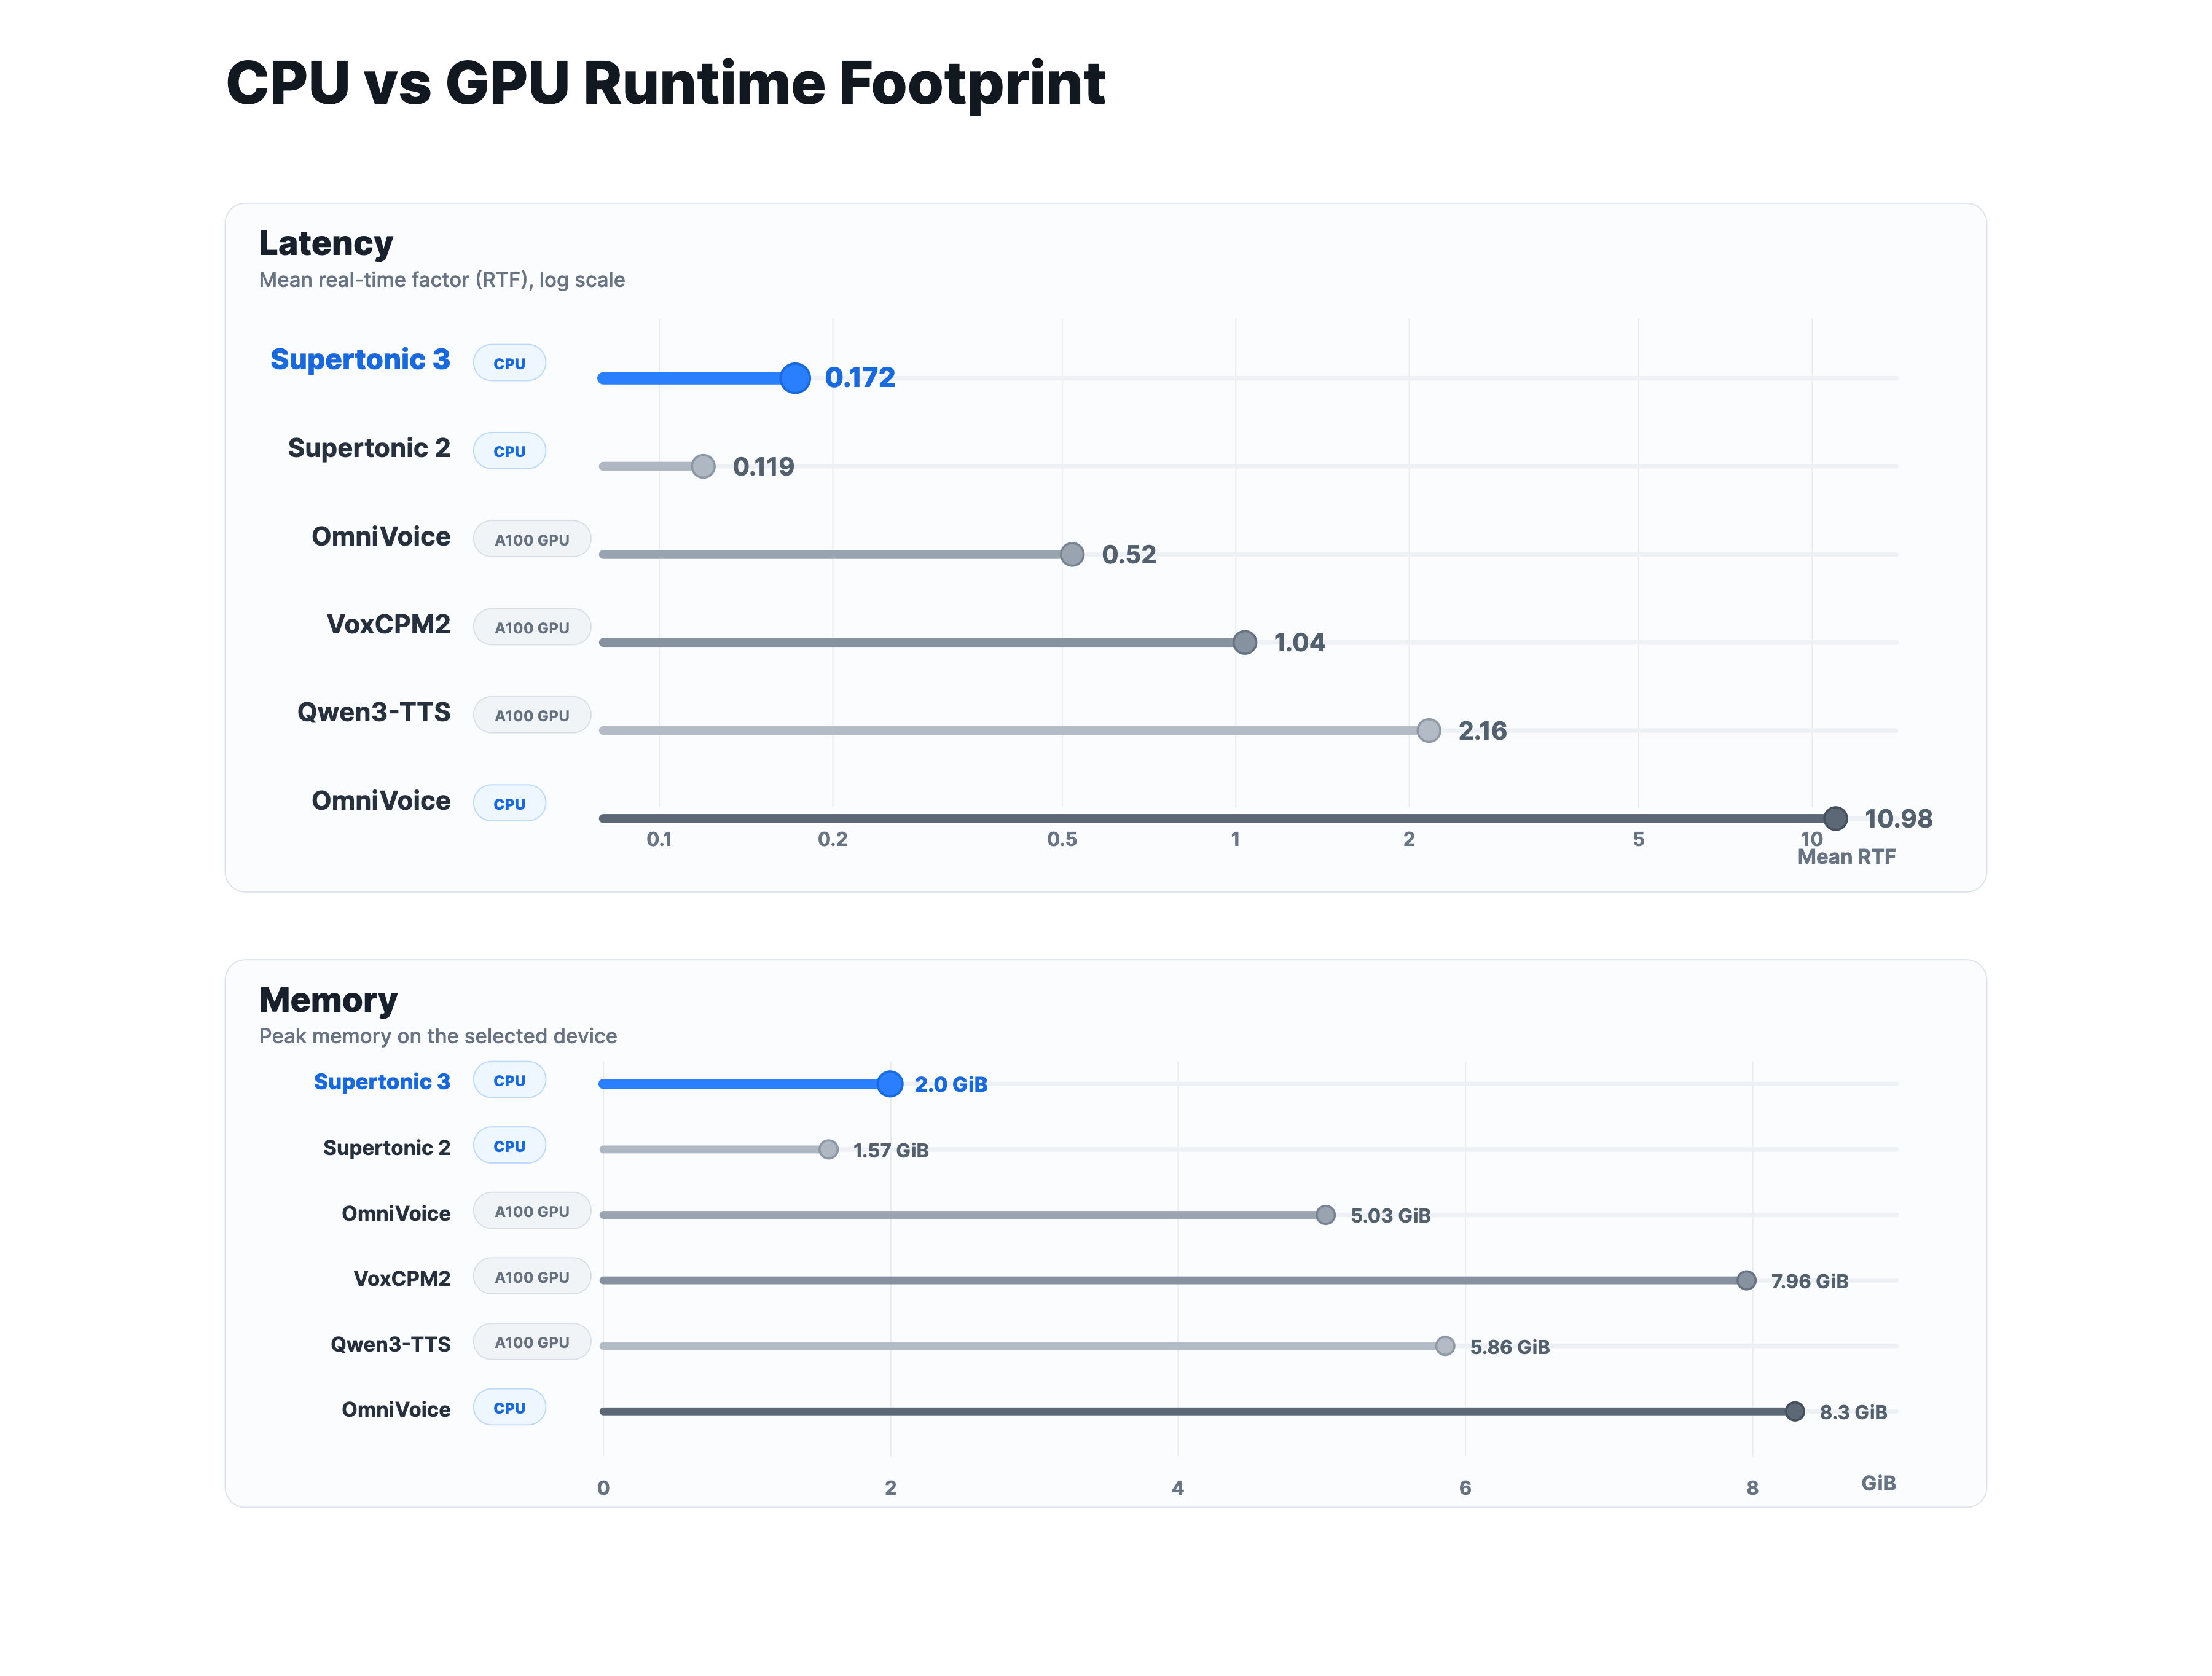
Fuente: gráfico oficial de rendimiento y memoria de Supertone, reproducido sin cambios.
| Supertonic 3 | |
|---|---|
| Parámetros | Unos 99 millones |
| Precisión de lectura | WER/CER competitivos frente a modelos mucho mayores |
| Velocidad demostrada | RTF 0.3× en un lector electrónico; tiempo real en una Pi |
| Salida | Voz a 44.1 kHz |
| Idiomas | 31 |
| Licencia | OpenRAIL-M |
| Función en Local TTS | La voz multilingüe de 31 idiomas |
La comparación directa que explica nuestra decisión
La comparación más directa procede de un benchmark independiente de terceros que ejecutó ambos modelos en la misma CPU modesta de 4 núcleos, sin GPU: condiciones más parecidas a un teléfono que a un servidor de IA. Dos resultados importan:
- Velocidad: Supertonic 3 sintetizó con un RTF de 0.313 en su ajuste de calidad estándar —unas 3.2 veces más rápido que el tiempo real—, mientras que Kokoro-82M midió un RTF de 0.469–0.509, en torno al doble del tiempo real. Ambos superan el tiempo real en una CPU pequeña; Supertonic lo hace con más margen.
- Naturalidad: la misma prueba juzgó más humana la voz inglesa de Kokoro, con una prosodia natural, mientras que los ajustes más rápidos de Supertonic sonaban más planos.
Dicho de otro modo, un evaluador independiente sin interés en ninguno de los dos modelos llegó a la misma conclusión que apuntan las cifras oficiales: Kokoro gana en naturalidad inglesa; Supertonic 3, en velocidad y amplitud. Si tuvieras que quedarte con un solo modelo, algo perderías. Local TTS decidió no elegir.
Por qué Local TTS conecta los dos modelos
Dentro de Local TTS, ambos motores trabajan detrás de un único lector. Cada voz de la lista pertenece a uno de los dos modelos, y al elegir una voz la aplicación dirige la síntesis al motor correcto de forma automática: el mismo botón de reproducción, el mismo resaltado, los mismos controles de velocidad y la misma garantía sin conexión.
El inglés va a Kokoro-82M
La razón son los resultados de preferencia humana. Cuando los oyentes votan una y otra vez un modelo de 82M por encima de sistemas de miles de millones de parámetros en inglés, ese es el modelo que merecen tus audiolibros, artículos y PDF en inglés. Local TTS incluye las 28 voces estadounidenses y británicas de Kokoro y las ejecuta con una ruta Core ML afinada para los chips de Apple, que además proporciona los tiempos de cada palabra para el resaltado palabra por palabra y sigue sintetizando durante la reproducción en segundo plano.
Todo lo multilingüe va a Supertonic 3
La razón son la cobertura y la eficiencia. Un único modelo Supertonic 3 incluido lee coreano, japonés, alemán, francés, español y 26 idiomas más a 44.1 kHz, con tasas de error competitivas frente a sistemas mucho mayores; y su diseño pensado para CPU hace que la lectura en segundo plano y los documentos largos sigan siendo viables con batería. Cada uno de sus diez estilos predefinidos (F1–F5, M1–M5) lee los 31 idiomas, así que un documento que cambia de idioma conserva una voz coherente.
Qué evita esta combinación
- Una aplicación solo en inglés. Kokoro por sí solo dejaría 30 idiomas sin una voz sólida.
- Una única voz inglesa más plana. Supertonic por sí solo sacrificaría la naturalidad inglesa ganadora de la arena y el catálogo de 28 voces inglesas.
- Un plan B en la nube. Ambos modelos son lo bastante pequeños para venir incluidos, así que ningún texto sale del dispositivo en busca de «el modelo mejor en un servidor».
El diseño combinado cuesta algo de tamaño de aplicación y de complejidad de ingeniería, y lo consideramos un buen trato: los benchmarks anteriores son, en la práctica, su hoja de especificaciones.
Descarga Local TTS gratis en el App Store y compara ambos motores con tu propio texto: tres voces inglesas de Kokoro y una voz multilingüe de Supertonic 3 son gratuitas.
Cómo leer estas cifras con honestidad
Los benchmarks orientan una decisión; no cierran la discusión. Conviene tener presentes cuatro matices:
- Las cifras originales no se midieron en un iPhone. Las clasificaciones de la arena, las tablas de WER y los valores de RTF proceden del hardware de quienes los publicaron. El rendimiento de Local TTS depende de tu dispositivo, tu texto y tus ajustes; el orden entre los modelos, en cambio, se ha mantenido en todas las pruebas independientes en CPU que hemos podido encontrar.
- Las clasificaciones de arena cambian. El n.º 1 de Kokoro es el registro oficial de su periodo de evaluación v0.19; cada mes entran modelos nuevos en las arenas. Lo que ese resultado dejó demostrado de forma duradera es que un modelo compacto puede ganar pruebas de escucha a ciegas en inglés.
- El WER/CER lo puntúa una transcripción automática. Mide si las palabras se pronunciaron correctamente, no si la lectura fue bonita; eso lo mide la arena con oyentes humanos, y por eso conviene leer ambas métricas juntas.
- Los ajustes de velocidad sacrifican calidad. Las configuraciones más rápidas de Supertonic reducen la naturalidad. Local TTS usa el ajuste equilibrado, no el que da titulares.
Preguntas frecuentes
¿De verdad Local TTS ejecuta ambos modelos en el dispositivo?
Sí. Kokoro-82M y Supertonic 3 vienen incluidos en la aplicación. El texto, los documentos y el audio generado se procesan en tu iPhone o iPad, sin servidor de voz.
¿Qué modelo escucharé realmente?
Depende de la voz que elijas. Las 28 voces de inglés estadounidense y británico son Kokoro-82M; los diez estilos multilingües (F1–F5, M1–M5) son Supertonic 3. Puedes cambiar por nota en cualquier momento.
¿Por qué no usar directamente los grandes ganadores como VoxCPM2 o Qwen3-TTS?
Esos sistemas son varias veces mayores y se evalúan en GPU de servidor. Local TTS está construido sobre modelos que funcionan sin conexión en un teléfono; dentro de esa restricción, estos dos son la combinación publicada más fuerte que conocemos.
¿Cuál es más rápido, Kokoro o Supertonic?
En la misma CPU pequeña, una prueba independiente midió Supertonic 3 en torno a 3 veces el tiempo real y Kokoro en torno a 2 veces. Ambos van sobrados para la lectura continua en Local TTS.
¿Suenan distintos los dos motores?
Sí, a propósito. Las voces de Kokoro son personalidades inglesas individuales; los estilos de Supertonic son narradores multilingües coherentes. Prueba varias voces con tu propio texto: la versión gratuita incluye ambos motores.
¿Algo de esto necesita conexión a Internet?
No. Ambos modelos generan la voz sin conexión. El modo avión es un buen sitio para comprobarlo.
Escucha los benchmarks por ti mismo
Los números explican un diseño; tus oídos lo confirman. Pega un artículo en inglés y escucha una voz de Kokoro; después pega un párrafo en español, coreano o alemán y oye cómo Supertonic 3 toma el relevo: la misma aplicación, la misma privacidad y ninguna nube de por medio.
Descarga Local TTS gratis en el App Store y escucha por qué usamos dos modelos en lugar de uno.
Para conocer cada motor a fondo, lee nuestra guía de Kokoro-82M y nuestra guía de Supertonic 3.
Cualquier texto se vuelve voz — sin conexión
Local TTS lee PDF, libros electrónicos y artículos en voz alta directamente en tu iPhone — en privado y con naturalidad.
Descargar en el App Store