
Inhalt
- Die Antwort in einem Satz
- Wie man die Leistung von Text-to-Speech misst
- Was die Benchmarks über Kokoro-82M sagen
- Was die Benchmarks über Supertonic 3 sagen
- Der direkte Vergleich, der unsere Entscheidung erklärt
- Warum Local TTS die beiden Modelle verbindet
- Wie man diese Zahlen ehrlich liest
- Häufig gestellte Fragen
- Hören Sie sich die Benchmarks selbst an
Local TTS bringt zwei neuronale Sprachmodelle mit statt nur eines. Kokoro-82M liest die amerikanischen und britischen englischen Stimmen, Supertonic 3 die mehrsprachige Stimme mit 31 Sprachen. Beide laufen vollständig auf Ihrem iPhone oder iPad.
Warum zwei Modelle mitliefern, wenn eines die App kleiner und einfacher machen würde? Weil die veröffentlichten Benchmarks eine klare Antwort geben: Kein einzelnes kompaktes On-Device-Modell gewinnt derzeit gleichzeitig bei Natürlichkeit, Lesegenauigkeit, Tempo und Sprachabdeckung. Jedes der beiden gewinnt ein anderes Rennen, und die Kombination erlaubt Local TTS, jedes Modell genau dort einzusetzen, wo es am stärksten ist.
Dieser Artikel geht die offiziellen Testergebnisse hinter dieser Entscheidung durch – was die Herausgeber der Modelle gemessen haben, was ein unabhängiger Test ergab und was davon in dem Reader ankommt, den Sie tatsächlich hören.
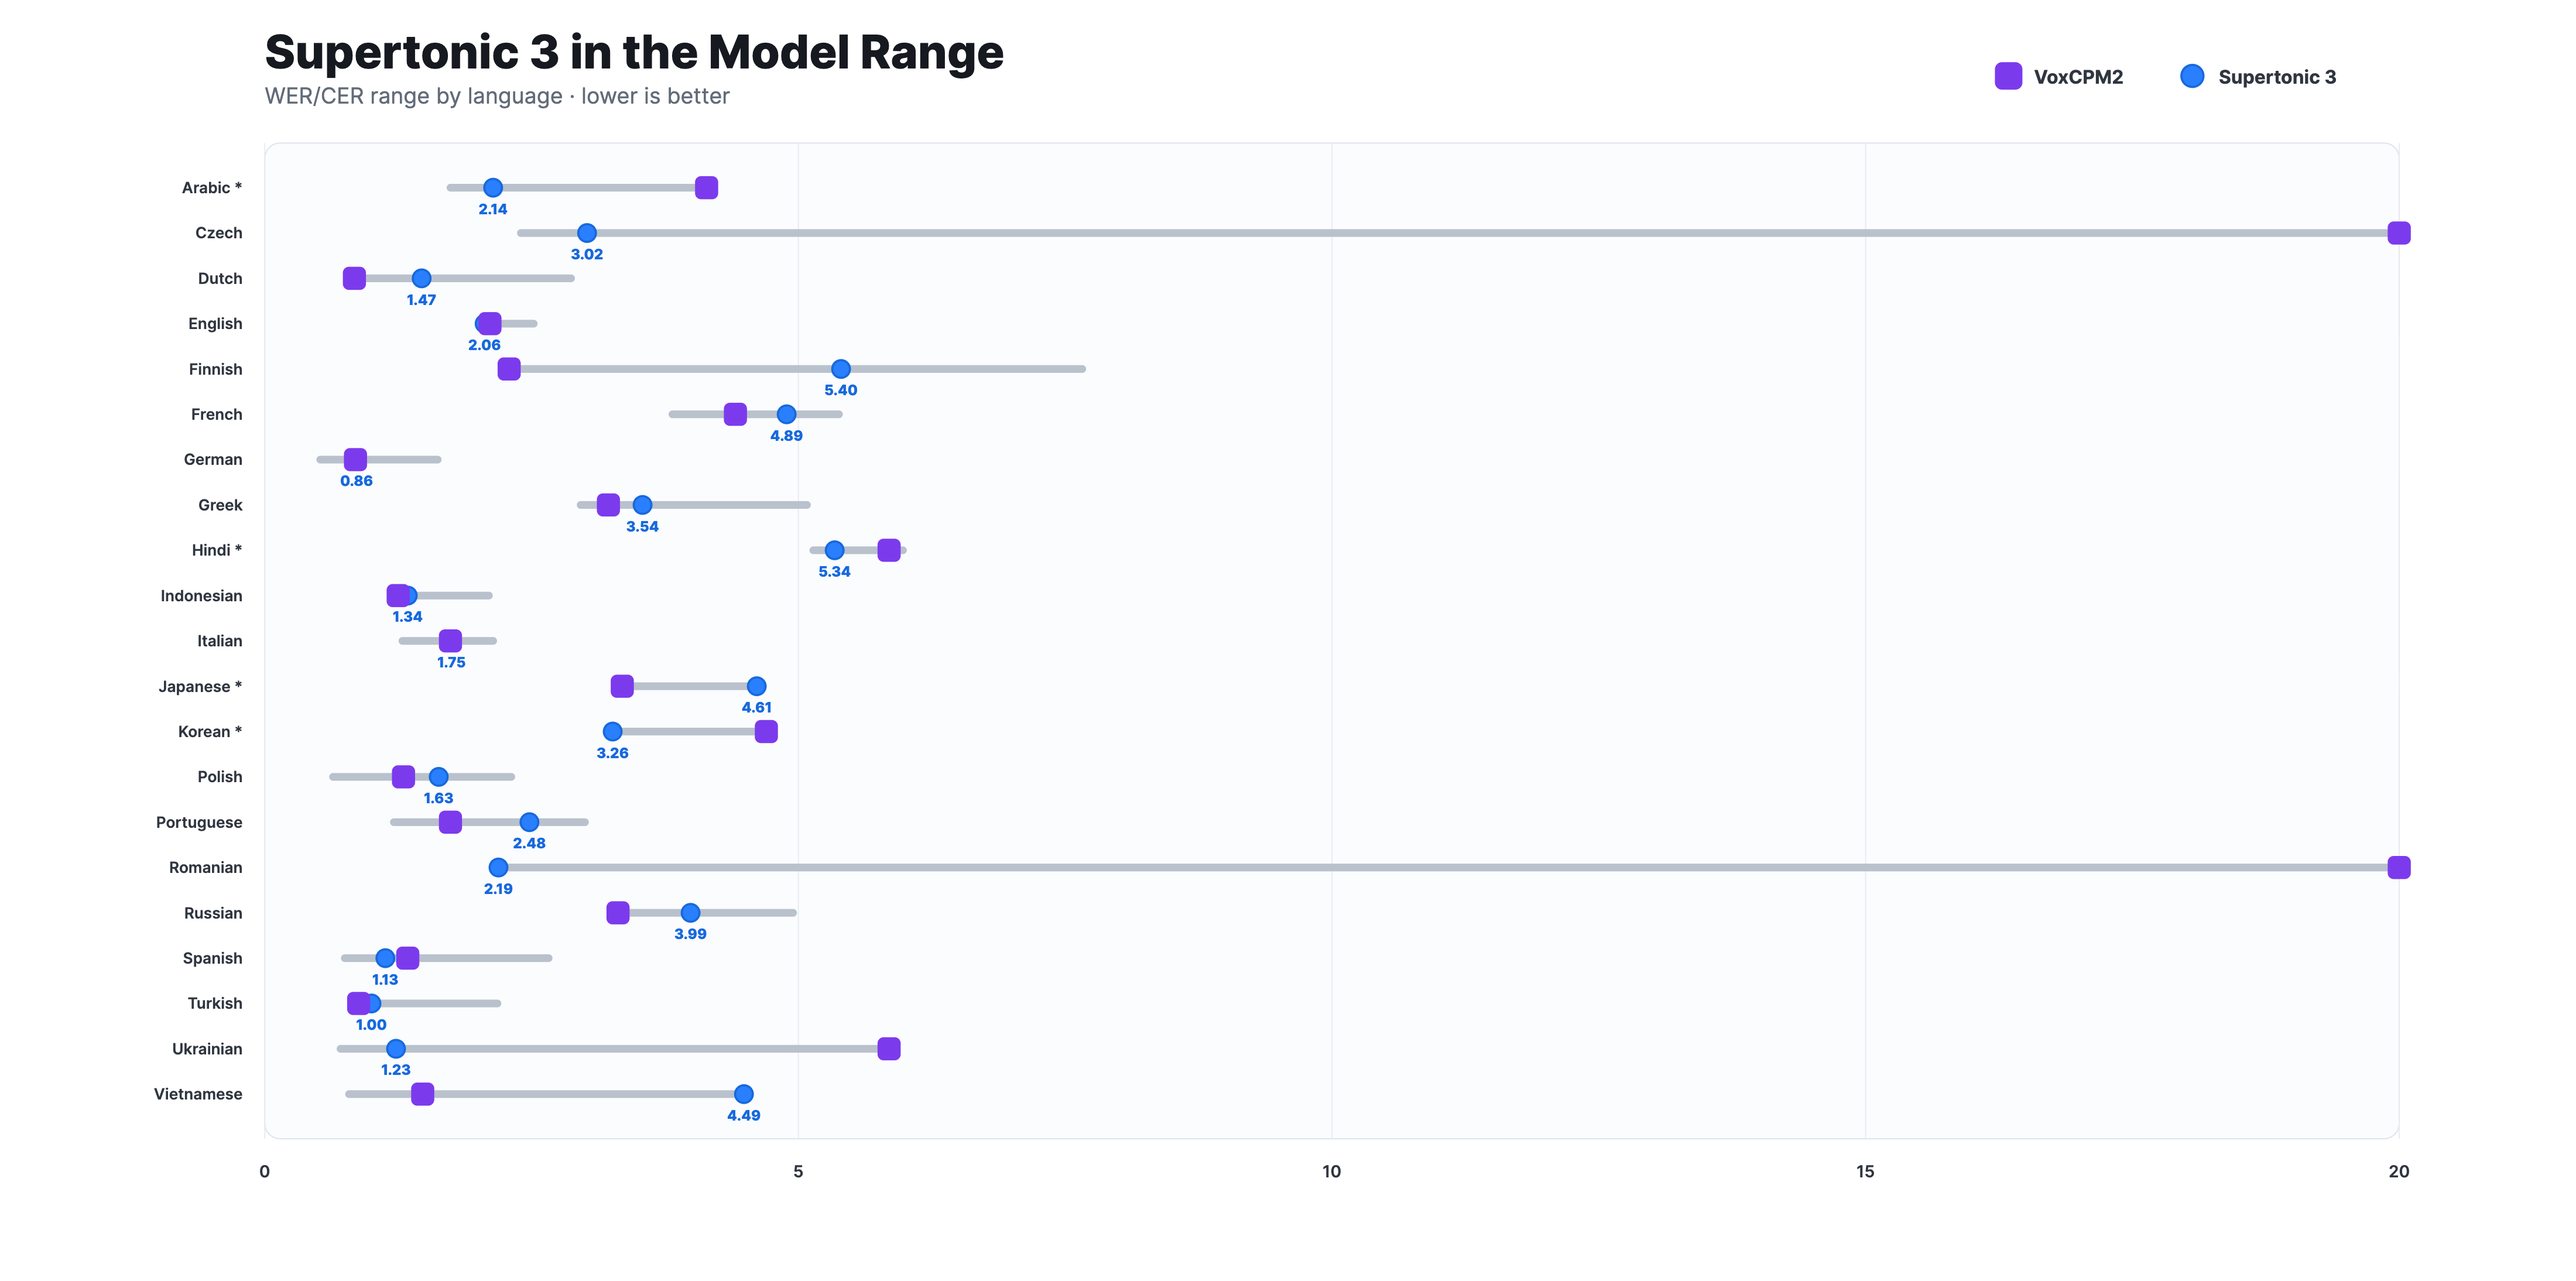
Quellen und Titelbild: Das Titelbild ist Supertone’s unverändertes offizielles Diagramm zur Lesegenauigkeit aus dem Supertonic-Repository. Die Kokoro-Werte stammen aus der offiziellen hexgrad/Kokoro-82M-Modellkarte, die Supertonic-Werte aus Supertone’s offiziellem Repository und der Modellkarte, der direkte CPU-Vergleich aus einem unabhängigen Benchmark eines Drittanbieters. Alle Zahlen wurden von ihren Herausgebern auf deren Hardware gemessen, nicht auf einem iPhone.
Die Antwort in einem Satz
Kokoro-82M führt bei menschlichen Natürlichkeitsbewertungen für Englisch, Supertonic 3 führt beim Tempo auf der CPU und liest 31 Sprachen mit konkurrenzfähiger Genauigkeit – deshalb leitet Local TTS Englisch an Kokoro und alles Mehrsprachige an Supertonic 3, komplett auf Ihrem Gerät.
Wie man die Leistung von Text-to-Speech misst
Für eine Vorlese-App zählen vier Messgrößen, und es hilft zu wissen, was jede davon bedeutet, bevor man auf die Zahlen schaut:
- Natürlichkeit wird von Menschen beurteilt. Der bekannteste öffentliche Test ist eine Blind-Arena: Hörer bekommen zwei anonyme Clips und stimmen für den natürlicheren – daraus entsteht eine Elo-artige Rangliste, die sich vom Marketing nicht beeinflussen lässt.
- Lesegenauigkeit fragt, ob das Modell den vorgegebenen Text auch wirklich gesprochen hat – ohne übersprungene, wiederholte oder verstümmelte Wörter. Bewertet wird sie als Wortfehlerrate (WER) oder Zeichenfehlerrate (CER), indem das erzeugte Audio automatisch zurück in Text transkribiert wird. Niedriger ist besser.
- Tempo wird als Echtzeitfaktor (RTF) angegeben: Synthesezeit geteilt durch Audiodauer. Ein RTF von 0,3 bedeutet, dass eine Sekunde Sprache in 0,3 Sekunden erzeugt wird – etwa 3,3-mal schneller als Echtzeit. Niedriger ist schneller.
- Fußabdruck umfasst Parameterzahl, Downloadgröße und Speicherbedarf – der Unterschied zwischen einem Modell, das in eine Smartphone-App passt, und einem, das eine Server-GPU braucht.
Eine Cloud-Stimme kann mit Rechenzentrums-Hardware allen vier Zielen gleichzeitig nachjagen. Ein On-Device-Modell muss Kompromisse eingehen – und genau hier trennen sich die Wege der beiden Modelle.
Was die Benchmarks über Kokoro-82M sagen
Das wichtigste Ergebnis von Kokoro-82M ist eine menschliche Präferenz-Rangliste. Vor dem v1.0-Release berichtete die offizielle Modellkarte, dass Kokoro v0.19 Platz 1 in der TTS Spaces Arena belegte, der Blind-Hör-Arena auf Hugging Face – mit einem höheren Elo-Wert als Modelle, die um ein Vielfaches größer sind, darunter XTTS v2 (467 Millionen Parameter) und MetaVoice (1,2 Milliarden Parameter). Trainiert wurde es mit nur einigen Hundert Stunden Audio.
Dieses Ergebnis ist ungewöhnlich genug für eine kurze Pause: In einem Test, in dem die Hörer weder Modellnamen noch Parameterzahlen sehen konnten, wurde ein Modell mit 82 Millionen Parametern Systemen mit Milliarden Parametern vorgezogen. Bei englischer Natürlichkeit pro Rechenaufwand setzte Kokoro den Maßstab für kompakte Modelle.
| Kokoro-82M v1.0 | |
|---|---|
| Parameter | 82 Millionen |
| Menschliche Bewertung | v0.19 auf Platz 1 der TTS Spaces Arena |
| Ausgabe | Sprache mit 24 kHz |
| Stimmen | 54 öffentliche Stimmen; 28 englische in Local TTS |
| Lizenz | Apache 2.0 |
| Rolle in Local TTS | Katalog für amerikanisches und britisches Englisch |
Der Kompromiss ist die Abdeckung. Kokoros öffentliche Version umfasst acht Sprachen, doch der eigene Stimmenkatalog merkt an, dass die Qualität außerhalb des Englischen je nach Trainingsdaten schwankt. Kokoro ist ein Spezialist: herausragend auf Englisch, dünn überall sonst.
Was die Benchmarks über Supertonic 3 sagen
Supertonic 3, am 29. April 2026 von Supertone veröffentlicht, wird in der entgegengesetzten Richtung bewertet: Breite und Effizienz. Das offizielle Repository veröffentlicht Ergebnisse zur Lesegenauigkeit auf dem Minimax-MLS-test-Benchmark und vergleicht das rund 99 Millionen Parameter große Modell mit deutlich größeren offenen TTS-Systemen wie VoxCPM2, OmniVoice und Qwen3-TTS.
Hier sind Supertone’s veröffentlichte Fehlerraten für die elf Sprachen, in denen diese Website geschrieben ist (niedriger ist besser; * markiert die Zeichenfehlerrate, alle übrigen Werte sind Wortfehlerraten):
| Sprache | VoxCPM2 | OmniVoice | Qwen3-TTS | Supertonic 3 |
|---|---|---|---|---|
| Englisch | 2,11 | 2,02 | 2,25 | 2,06 |
| Koreanisch* | 4,70 | 3,22 | 4,07 | 3,26 |
| Japanisch* | 3,35 | 3,81 | 3,67 | 4,61 |
| Deutsch | 0,85 | 0,96 | 0,52 | 0,86 |
| Französisch | 4,41 | 4,74 | 3,82 | 4,89 |
| Spanisch | 1,34 | 0,99 | 0,75 | 1,13 |
| Portugiesisch | 1,74 | 1,40 | 1,21 | 2,48 |
| Italienisch | 1,74 | 1,29 | 1,40 | 1,75 |
| Niederländisch | 0,84 | 0,77 | — | 1,47 |
| Polnisch | 1,30 | 0,64 | — | 1,63 |
| Türkisch | 0,88 | 2,18 | — | 1,00 |
Supertonic 3 gewinnt nicht jede Zeile, und Supertone behauptet das auch nicht. Das offizielle Fazit ist nützlicher: Das Modell bleibt im konkurrenzfähigen Fehlerbereich von Systemen, die um ein Mehrfaches größer sind – über 31 Sprachen hinweg und dabei klein genug, um ganz ohne GPU zu laufen.
Beim Tempo stechen die Zahlen heraus. Supertone demonstriert Supertonic 3 auf Hardware, die weit schwächer ist als ein modernes iPhone: auf einem Onyx Boox Go 6 E-Reader im Flugmodus mit einem durchschnittlichen RTF von 0,3× – rund dreimal schneller als Echtzeit auf einem E-Reader – und mit Echtzeit-Synthese auf einem Raspberry Pi. Der offizielle Laufzeitvergleich zeigt das Modell auf gewöhnlichen CPUs schnell, selbst gegen größere Vergleichsmodelle, die auf einer NVIDIA-A100-Server-GPU gemessen wurden – bei deutlich geringerem Speicherverbrauch.
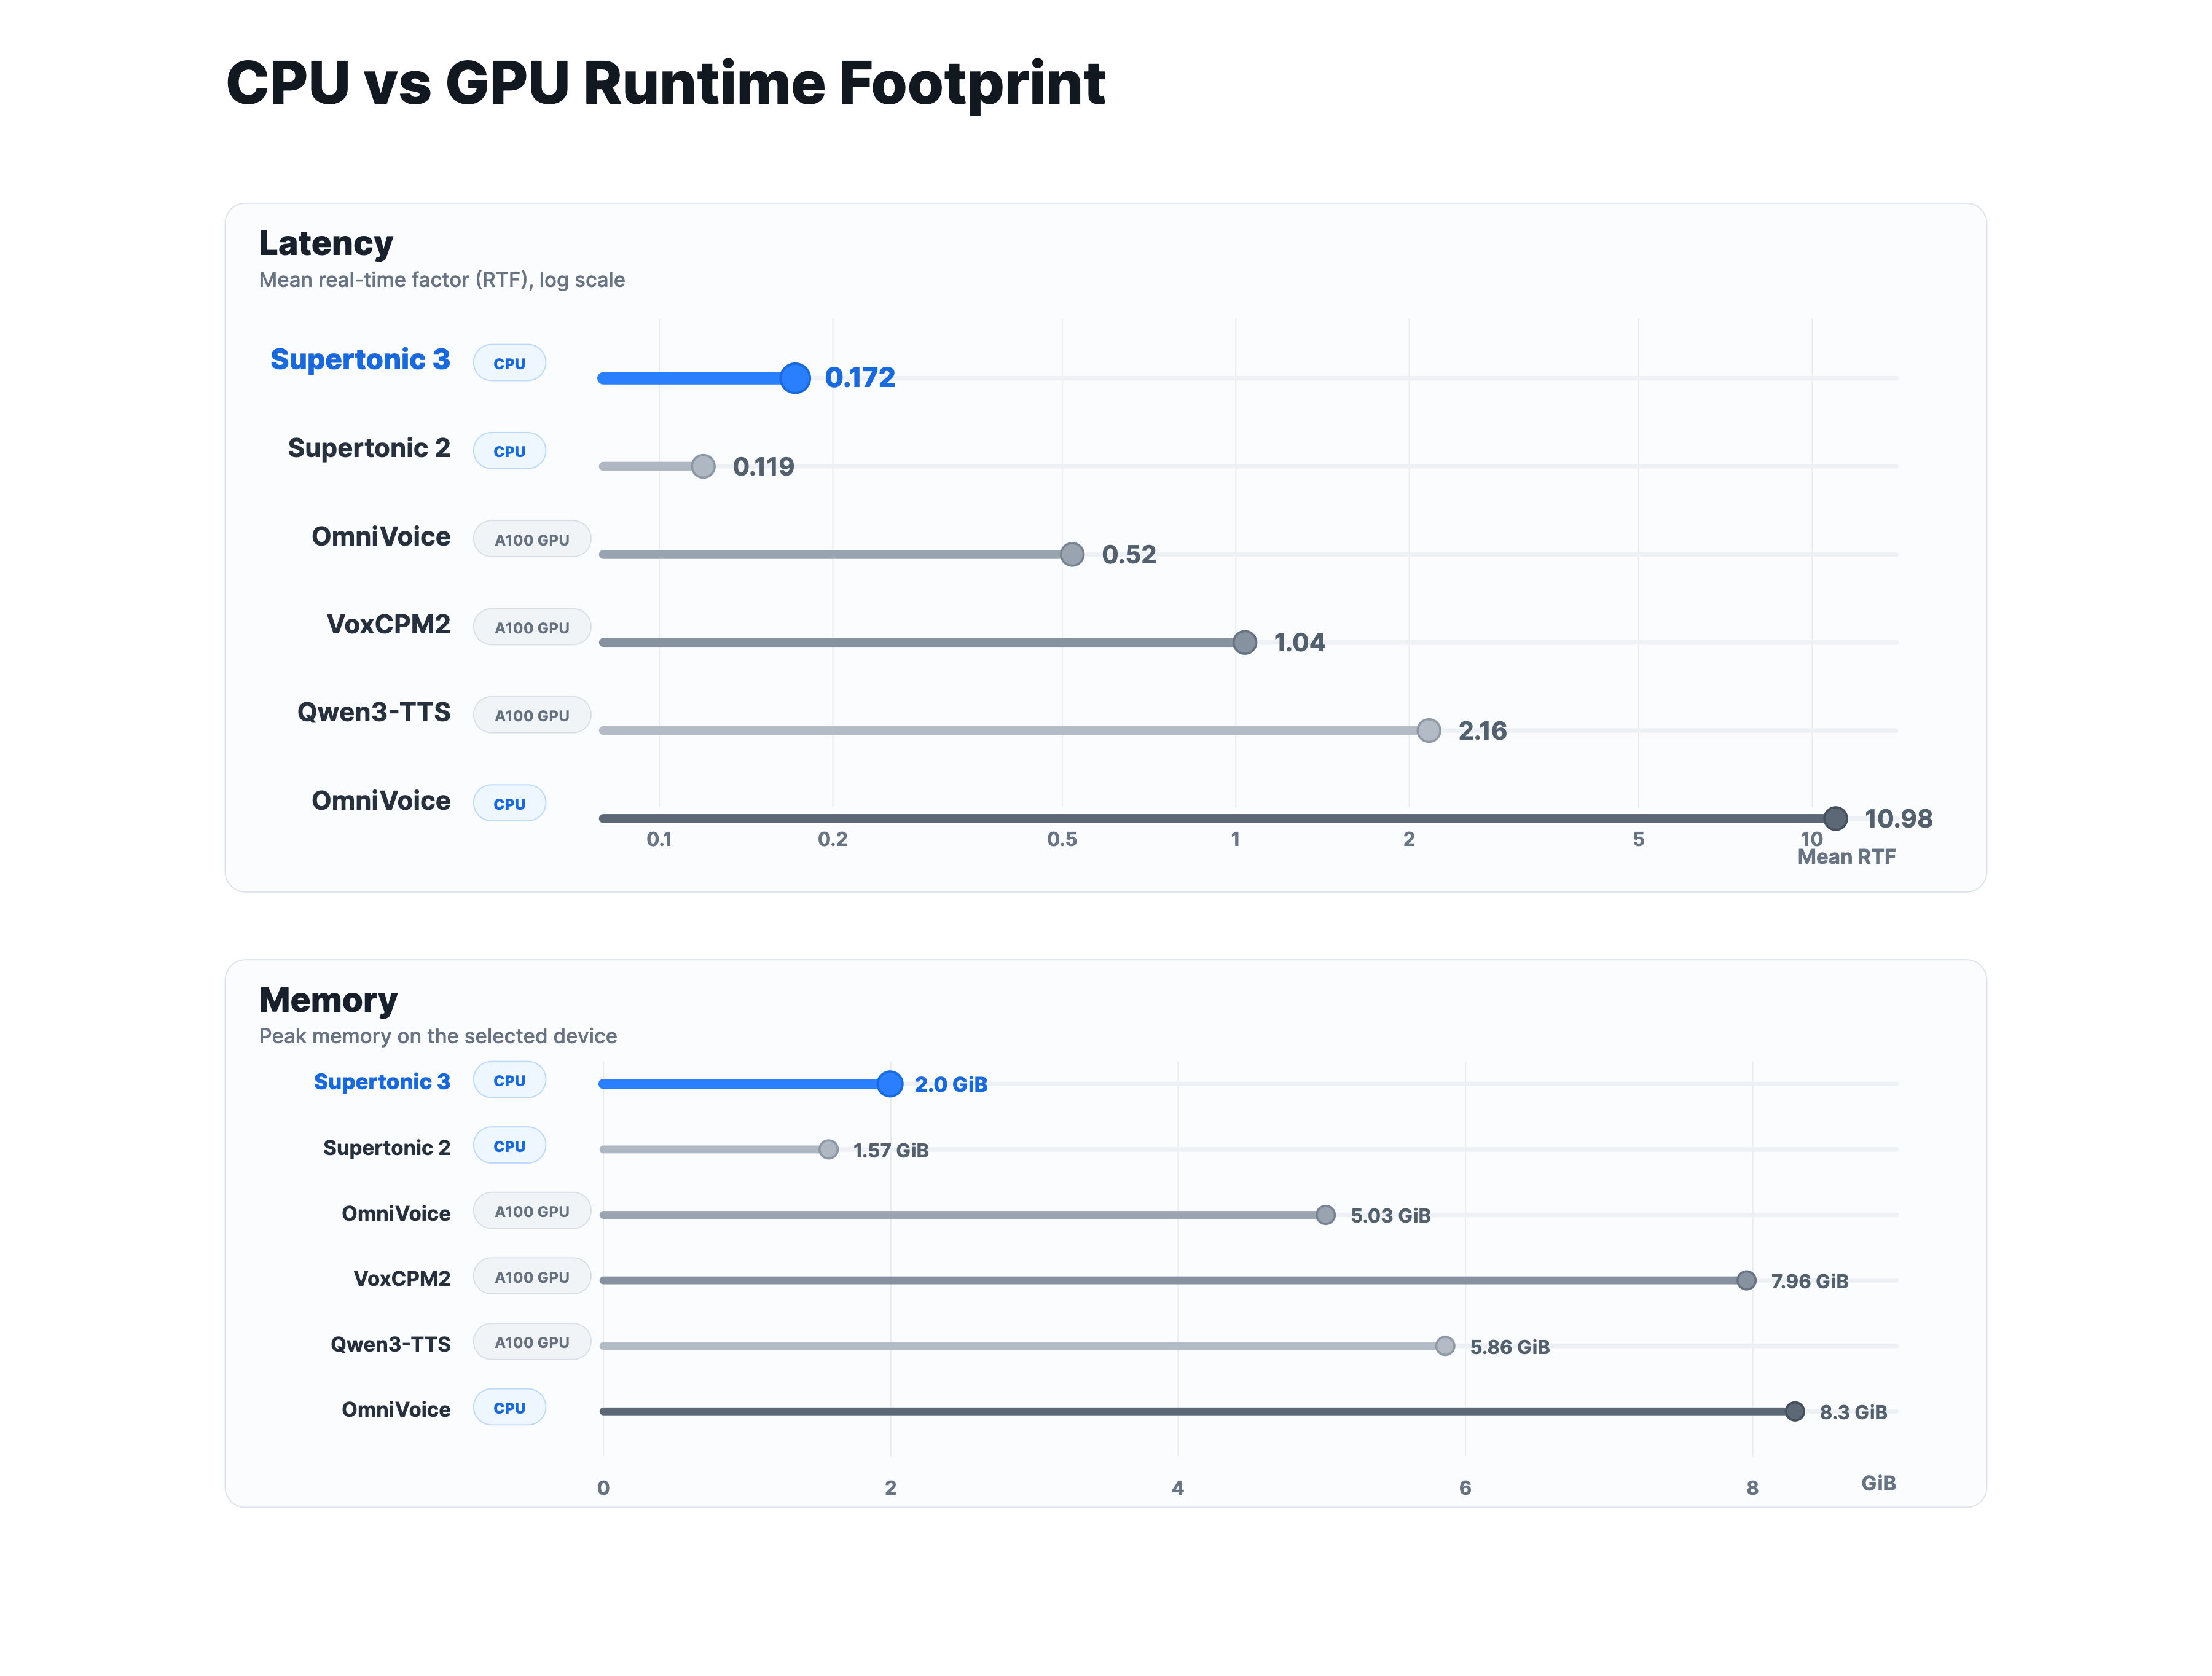
Quelle: Supertone’s offizielles Laufzeitdiagramm, unverändert übernommen.
| Supertonic 3 | |
|---|---|
| Parameter | Rund 99 Millionen |
| Lesegenauigkeit | Konkurrenzfähige WER/CER vs. weit größere Modelle |
| Demonstriertes Tempo | RTF 0,3× auf einem E-Reader; Echtzeit auf dem Pi |
| Ausgabe | Sprache mit 44,1 kHz |
| Sprachen | 31 |
| Lizenz | OpenRAIL-M |
| Rolle in Local TTS | Die mehrsprachige Stimme mit 31 Sprachen |
Der direkte Vergleich, der unsere Entscheidung erklärt
Der direkteste Vergleich stammt aus einem unabhängigen Benchmark eines Drittanbieters, der beide Modelle auf derselben bescheidenen 4-Kern-CPU ohne GPU laufen ließ – Bedingungen, die einem Smartphone näher sind als einem KI-Server. Zwei Ergebnisse zählen:
- Tempo: Supertonic 3 synthetisierte in der Standard-Qualitätsstufe mit RTF 0,313 – etwa 3,2-mal schneller als Echtzeit –, während Kokoro-82M auf RTF 0,469–0,509 kam, rund 2-mal Echtzeit. Beide sind auf einer kleinen CPU schneller als Echtzeit; Supertonic hat den größeren Vorsprung.
- Natürlichkeit: Derselbe Test bewertete Kokoros englische Ausgabe als die menschlichere, mit natürlichem Sprachrhythmus, während Supertonics schnellste Einstellungen flacher klangen.
Mit anderen Worten: Ein unabhängiger Tester ohne Interesse an einem der beiden Modelle kam zum selben Schluss, auf den auch die offiziellen Zahlen zeigen: Kokoro gewinnt bei englischer Natürlichkeit, Supertonic 3 bei Tempo und Breite. Wer nur ein Modell wählen dürfte, müsste etwas aufgeben. Local TTS hat sich entschieden, sich nicht zu entscheiden.
Warum Local TTS die beiden Modelle verbindet
In Local TTS sitzen beide Engines hinter einem einzigen Reader. Jede Stimme in der Stimmenliste gehört zu einem der beiden Modelle, und sobald Sie eine Stimme wählen, leitet die App die Synthese automatisch an die richtige Engine – gleiche Wiedergabetaste, gleiche Hervorhebung, gleiche Temporegler, gleiche Offline-Garantie.
Englisch geht an Kokoro-82M
Der Grund sind die menschlichen Präferenzergebnisse. Wenn Hörer ein 82M-Modell bei Englisch beständig über Systeme mit Milliarden Parametern stellen, dann ist das das Modell, das Ihre englischen Hörbücher, Artikel und PDFs bekommen sollten. Local TTS bündelt alle 28 amerikanischen und britischen Kokoro-Stimmen und führt sie durch eine für Apple Silicon abgestimmte Core-ML-Pipeline. Sie liefert auch die Wortzeitpunkte für die wortweise Hervorhebung – und synthetisiert bei Hintergrundwiedergabe weiter.
Alles Mehrsprachige geht an Supertonic 3
Der Grund sind Abdeckung und Effizienz. Ein einziges gebündeltes Supertonic-3-Modell liest Koreanisch, Japanisch, Deutsch, Französisch, Spanisch und 26 weitere Sprachen mit 44,1 kHz – mit Fehlerraten, die mit weit größeren Systemen mithalten. Und weil das Modell für die CPU ausgelegt ist, bleiben Hintergrundwiedergabe und lange Dokumente auch im Akkubetrieb praktikabel. Zehn voreingestellte Stile (F1–F5, M1–M5) lesen jeweils alle 31 Sprachen, sodass ein Dokument, das die Sprache wechselt, eine konsistente Stimme behält.
Was die Kombination vermeidet
- Eine App nur für Englisch. Kokoro allein ließe 30 Sprachen ohne starke Stimme zurück.
- Eine einzelne, flachere englische Stimme. Supertonic allein würde die in der Arena prämierte englische Natürlichkeit und den Katalog mit 28 englischen Stimmen opfern.
- Einen Cloud-Fallback. Beide Modelle sind klein genug, um mitgeliefert zu werden – kein Text muss das Gerät verlassen, um „das bessere Modell auf einem Server“ zu erreichen.
Das kombinierte Design kostet etwas App-Größe und Entwicklungsaufwand, und wir halten das für einen guten Tausch: Die Benchmarks oben sind im Grunde seine Spezifikation.
Laden Sie Local TTS kostenlos im App Store und vergleichen Sie beide Engines mit Ihrem eigenen Text – drei englische Kokoro-Stimmen und eine mehrsprachige Supertonic-3-Stimme sind kostenlos.
Wie man diese Zahlen ehrlich liest
Benchmarks begründen eine Entscheidung; sie beenden nicht die Diskussion. Vier Einschränkungen sollte man im Kopf behalten:
- Die Originalzahlen wurden nicht auf einem iPhone gemessen. Arena-Ranglisten, WER-Tabellen und RTF-Werte stammen von der Hardware ihrer Herausgeber. Die Leistung von Local TTS hängt von Ihrem Gerät, Ihrem Text und Ihren Einstellungen ab; die Rangfolge der Modelle hat sich in den unabhängigen CPU-Tests, die wir finden konnten, allerdings bestätigt.
- Arena-Ranglisten bewegen sich. Kokoros Platz 1 ist das offizielle Ergebnis aus dem Bewertungszeitraum von v0.19; jeden Monat treten neue Modelle in Arenen an. Dauerhaft belegt hat das Ergebnis vor allem eines: Kompakte Modelle können blinde englische Hörtests gewinnen.
- WER/CER wird per maschineller Transkription bewertet. Die Metrik misst, ob Wörter korrekt gesprochen wurden – nicht, ob der Vortrag schön klang. Das misst die menschliche Arena, weshalb man beide Metriken am besten zusammen liest.
- Tempo-Einstellungen kosten Qualität. Supertonics allerschnellste Konfigurationen senken die Natürlichkeit. Local TTS verwendet die ausgewogene Einstellung, nicht die für Schlagzeilen.
Häufig gestellte Fragen
Führt Local TTS wirklich beide Modelle auf dem Gerät aus?
Ja. Kokoro-82M und Supertonic 3 sind beide in der App enthalten. Text, Dokumente und erzeugtes Audio werden auf Ihrem iPhone oder iPad verarbeitet – ohne Sprachserver.
Welches Modell höre ich tatsächlich?
Das richtet sich nach Ihrer Stimmwahl. Die 28 amerikanischen und britischen englischen Stimmen sind Kokoro-82M; die zehn mehrsprachigen Stile (F1–F5, M1–M5) sind Supertonic 3. Sie können pro Notiz jederzeit wechseln.
Warum nicht einfach die größeren Benchmark-Sieger wie VoxCPM2 oder Qwen3-TTS verwenden?
Diese Systeme sind um ein Mehrfaches größer und werden auf Server-GPUs gemessen. Local TTS ist um Modelle herum gebaut, die offline auf einem Smartphone laufen – und innerhalb dieser Grenze sind diese beiden die stärkste veröffentlichte Kombination, die wir kennen.
Ist Kokoro schneller oder Supertonic?
Auf derselben kleinen CPU maß der unabhängige Test Supertonic 3 mit rund 3-mal Echtzeit und Kokoro mit rund 2-mal Echtzeit. Beide sind komfortabel schnell genug für durchgehendes Vorlesen in Local TTS.
Klingen die beiden Engines unterschiedlich?
Ja, ganz bewusst. Kokoro-Stimmen sind individuelle englische Charaktere; Supertonic-Stile sind konsistente mehrsprachige Erzähler. Hören Sie ein paar Stimmen mit Ihrem eigenen Text an – die kostenlose Version enthält beide Engines.
Braucht irgendetwas davon eine Internetverbindung?
Nein. Beide Modelle erzeugen Sprache offline. Der Flugmodus ist ein guter Ort, um diese Aussage zu überprüfen.
Hören Sie sich die Benchmarks selbst an
Zahlen erklären ein Design; Ihre Ohren bestätigen es. Fügen Sie einen englischen Artikel ein und hören Sie einer Kokoro-Stimme zu. Fügen Sie dann einen deutschen, koreanischen oder spanischen Absatz ein und hören Sie, wie Supertonic 3 übernimmt – gleiche App, gleiche Privatsphäre, keine Cloud dazwischen.
Laden Sie Local TTS kostenlos im App Store und hören Sie, warum wir zwei Modelle statt eines verwenden.
Einen tieferen Blick auf die einzelnen Engines bieten unser Kokoro-82M-Leitfaden und unser Supertonic-3-Leitfaden.
Jeder Text wird Sprache — offline
Local TTS liest PDFs, E-Books und Artikel direkt auf deinem iPhone vor — privat und natürlich.
Im App Store laden