
Sommaire
- La réponse en une phrase
- Comment mesure-t-on une synthèse vocale ?
- Ce que disent les benchmarks de Kokoro-82M
- Ce que disent les benchmarks de Supertonic 3
- Le face-à-face qui explique notre choix
- Pourquoi Local TTS associe les deux modèles
- Comment lire ces chiffres honnêtement
- Questions fréquentes
- Écoutez les benchmarks par vous-même
Local TTS embarque deux modèles vocaux neuronaux au lieu d’un seul. Kokoro-82M lit ses voix en anglais américain et britannique, et Supertonic 3 lit sa voix multilingue en 31 langues. Les deux fonctionnent entièrement sur votre iPhone ou iPad.
Pourquoi embarquer deux modèles alors qu’un seul rendrait l’application plus légère et plus simple ? Parce que les benchmarks publiés donnent une réponse claire : aucun modèle compact fonctionnant sur l’appareil ne domine aujourd’hui à la fois le naturel, la précision de lecture, la vitesse et la couverture linguistique. Chacun des deux gagne une course différente, et les associer permet à Local TTS d’utiliser chaque modèle exactement là où il excelle.
Cet article passe en revue les résultats d’évaluation officiels derrière cette décision : ce que les éditeurs des modèles ont mesuré, ce qu’un test indépendant a constaté, et ce que cela change pour le lecteur que vous entendez réellement.
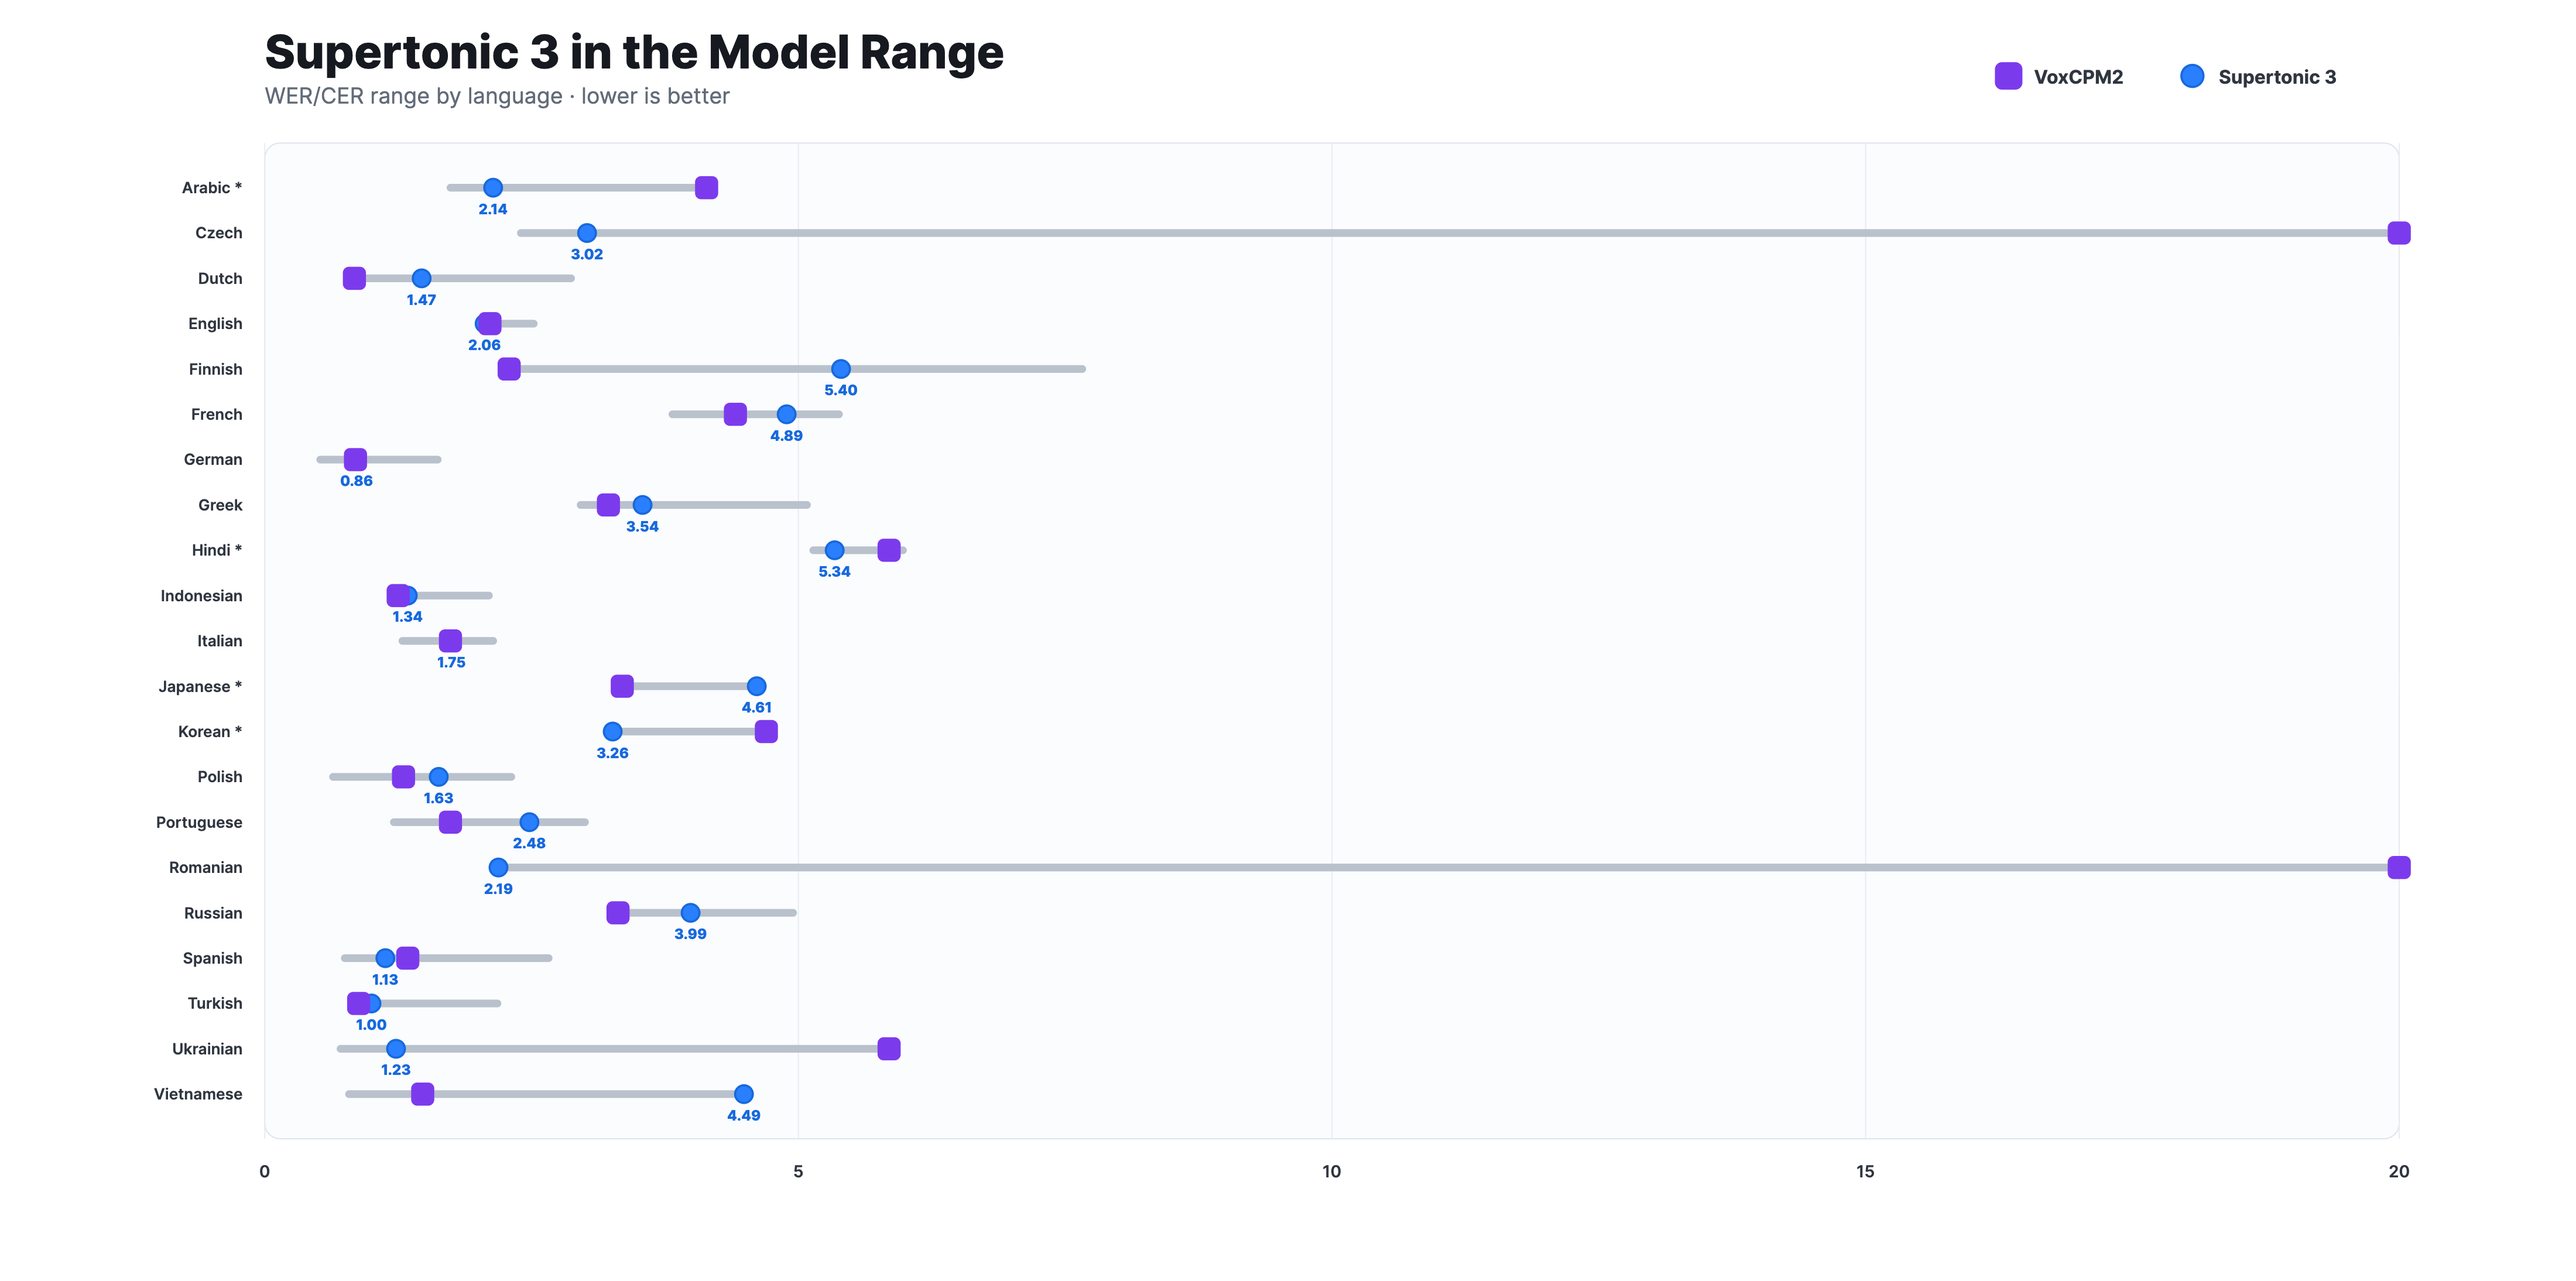
Sources et image de couverture : La couverture reprend sans modification le graphique officiel de précision de lecture publié par Supertone dans le dépôt Supertonic. Les chiffres de Kokoro sont cités depuis la fiche officielle du modèle hexgrad/Kokoro-82M ; ceux de Supertonic depuis le dépôt officiel de Supertone et sa fiche de modèle ; le face-à-face sur CPU depuis un benchmark tiers indépendant. Ces chiffres amont ont été mesurés par leurs éditeurs sur leur propre matériel, pas sur un iPhone.
La réponse en une phrase
Kokoro-82M domine les évaluations humaines de naturel en anglais ; Supertonic 3 est le plus rapide sur CPU et lit 31 langues avec une précision compétitive. Local TTS confie donc l’anglais à Kokoro et tout le multilingue à Supertonic 3, entièrement sur votre appareil.
Comment mesure-t-on une synthèse vocale ?
Quatre mesures comptent pour une application de lecture, et mieux vaut savoir ce que chacune signifie avant de regarder les chiffres :
- Le naturel est jugé par des personnes. Le test public le plus connu est une arène à l’aveugle : les auditeurs écoutent deux extraits anonymes et votent pour le plus naturel, ce qui produit un classement de type Elo que le marketing ne peut pas influencer.
- La précision de lecture vérifie que le modèle a bien prononcé le texte fourni — sans mots sautés, répétés ou déformés. Elle est notée en taux d’erreur par mot (WER) ou par caractère (CER), en retranscrivant l’audio généré en texte. Plus le score est bas, mieux c’est.
- La vitesse s’exprime par le facteur temps réel (RTF) : le temps de synthèse divisé par la durée de l’audio. Un RTF de 0,3 signifie qu’une seconde de parole demande 0,3 seconde de calcul — environ 3,3 fois plus vite que le temps réel. Plus c’est bas, plus c’est rapide.
- L’empreinte couvre le nombre de paramètres, la taille de téléchargement et la mémoire — la différence entre un modèle qui tient dans une application mobile et un modèle qui exige un GPU serveur.
Une voix cloud peut viser les quatre grâce au matériel d’un centre de données. Un modèle sur l’appareil doit faire des compromis, et c’est là que les deux modèles divergent.
Ce que disent les benchmarks de Kokoro-82M
Le résultat phare de Kokoro-82M est un classement par préférence humaine. Avant la sortie de sa version 1.0, la fiche officielle du modèle indiquait que Kokoro v0.19 s’était classé n° 1 de la TTS Spaces Arena, l’arène d’écoute à l’aveugle de Hugging Face — avec un score Elo supérieur à celui de modèles bien plus grands, dont XTTS v2 (467 millions de paramètres) et MetaVoice (1,2 milliard de paramètres), après un entraînement sur seulement quelques centaines d’heures d’audio.
C’est un résultat inhabituel qui mérite qu’on s’y arrête. Dans un test où les auditeurs ne voyaient ni les noms des modèles ni leur taille, un modèle de 82 millions de paramètres a été préféré à des systèmes qui en comptent des milliards. Pour le naturel anglais par unité de calcul, Kokoro a fixé la référence des modèles compacts.
| Kokoro-82M v1.0 | |
|---|---|
| Paramètres | 82 millions |
| Évaluation humaine | v0.19 classé n° 1 de la TTS Spaces Arena |
| Sortie | Voix à 24 kHz |
| Voix | 54 voix publiques ; 28 voix anglaises dans Local TTS |
| Licence | Apache 2.0 |
| Rôle dans Local TTS | Catalogue anglais américain et britannique |
La contrepartie, c’est la couverture. La version publique de Kokoro couvre huit langues, mais son propre catalogue vocal précise que la qualité hors anglais varie selon les données d’entraînement. C’est un spécialiste : excellent en anglais, limité ailleurs.
Ce que disent les benchmarks de Supertonic 3
Supertonic 3, publié par Supertone le 29 avril 2026, est évalué dans la direction opposée : la couverture et l’efficacité. Le dépôt officiel publie des résultats de précision de lecture sur le benchmark Minimax-MLS-test, comparant son modèle d’environ 99 millions de paramètres à des systèmes TTS ouverts bien plus grands comme VoxCPM2, OmniVoice et Qwen3-TTS.
Voici les taux d’erreur publiés par Supertone pour les onze langues dans lesquelles ce site est rédigé (plus bas = meilleur ; * indique un taux d’erreur par caractère, les autres un taux d’erreur par mot) :
| Langue | VoxCPM2 | OmniVoice | Qwen3-TTS | Supertonic 3 |
|---|---|---|---|---|
| Anglais | 2,11 | 2,02 | 2,25 | 2,06 |
| Coréen* | 4,70 | 3,22 | 4,07 | 3,26 |
| Japonais* | 3,35 | 3,81 | 3,67 | 4,61 |
| Allemand | 0,85 | 0,96 | 0,52 | 0,86 |
| Français | 4,41 | 4,74 | 3,82 | 4,89 |
| Espagnol | 1,34 | 0,99 | 0,75 | 1,13 |
| Portugais | 1,74 | 1,40 | 1,21 | 2,48 |
| Italien | 1,74 | 1,29 | 1,40 | 1,75 |
| Néerlandais | 0,84 | 0,77 | — | 1,47 |
| Polonais | 1,30 | 0,64 | — | 1,63 |
| Turc | 0,88 | 2,18 | — | 1,00 |
Supertonic 3 ne gagne pas chaque ligne, et Supertone ne prétend pas le contraire. La conclusion officielle est plus utile : le modèle reste dans la fourchette d’erreur compétitive de systèmes plusieurs fois plus grands, sur 31 langues, tout en étant assez léger pour fonctionner sans aucun GPU.
C’est sur la vitesse que ses chiffres se démarquent. Supertone fait tourner Supertonic 3 sur du matériel bien plus faible qu’un iPhone récent : une liseuse Onyx Boox Go 6 en mode avion, avec un RTF moyen de 0,3× — environ trois fois plus vite que le temps réel sur une liseuse — et une synthèse en temps réel sur un Raspberry Pi. Le comparatif officiel des temps d’exécution le montre rapide sur des CPU ordinaires, même face à des modèles plus grands mesurés sur un GPU serveur NVIDIA A100, tout en consommant nettement moins de mémoire.
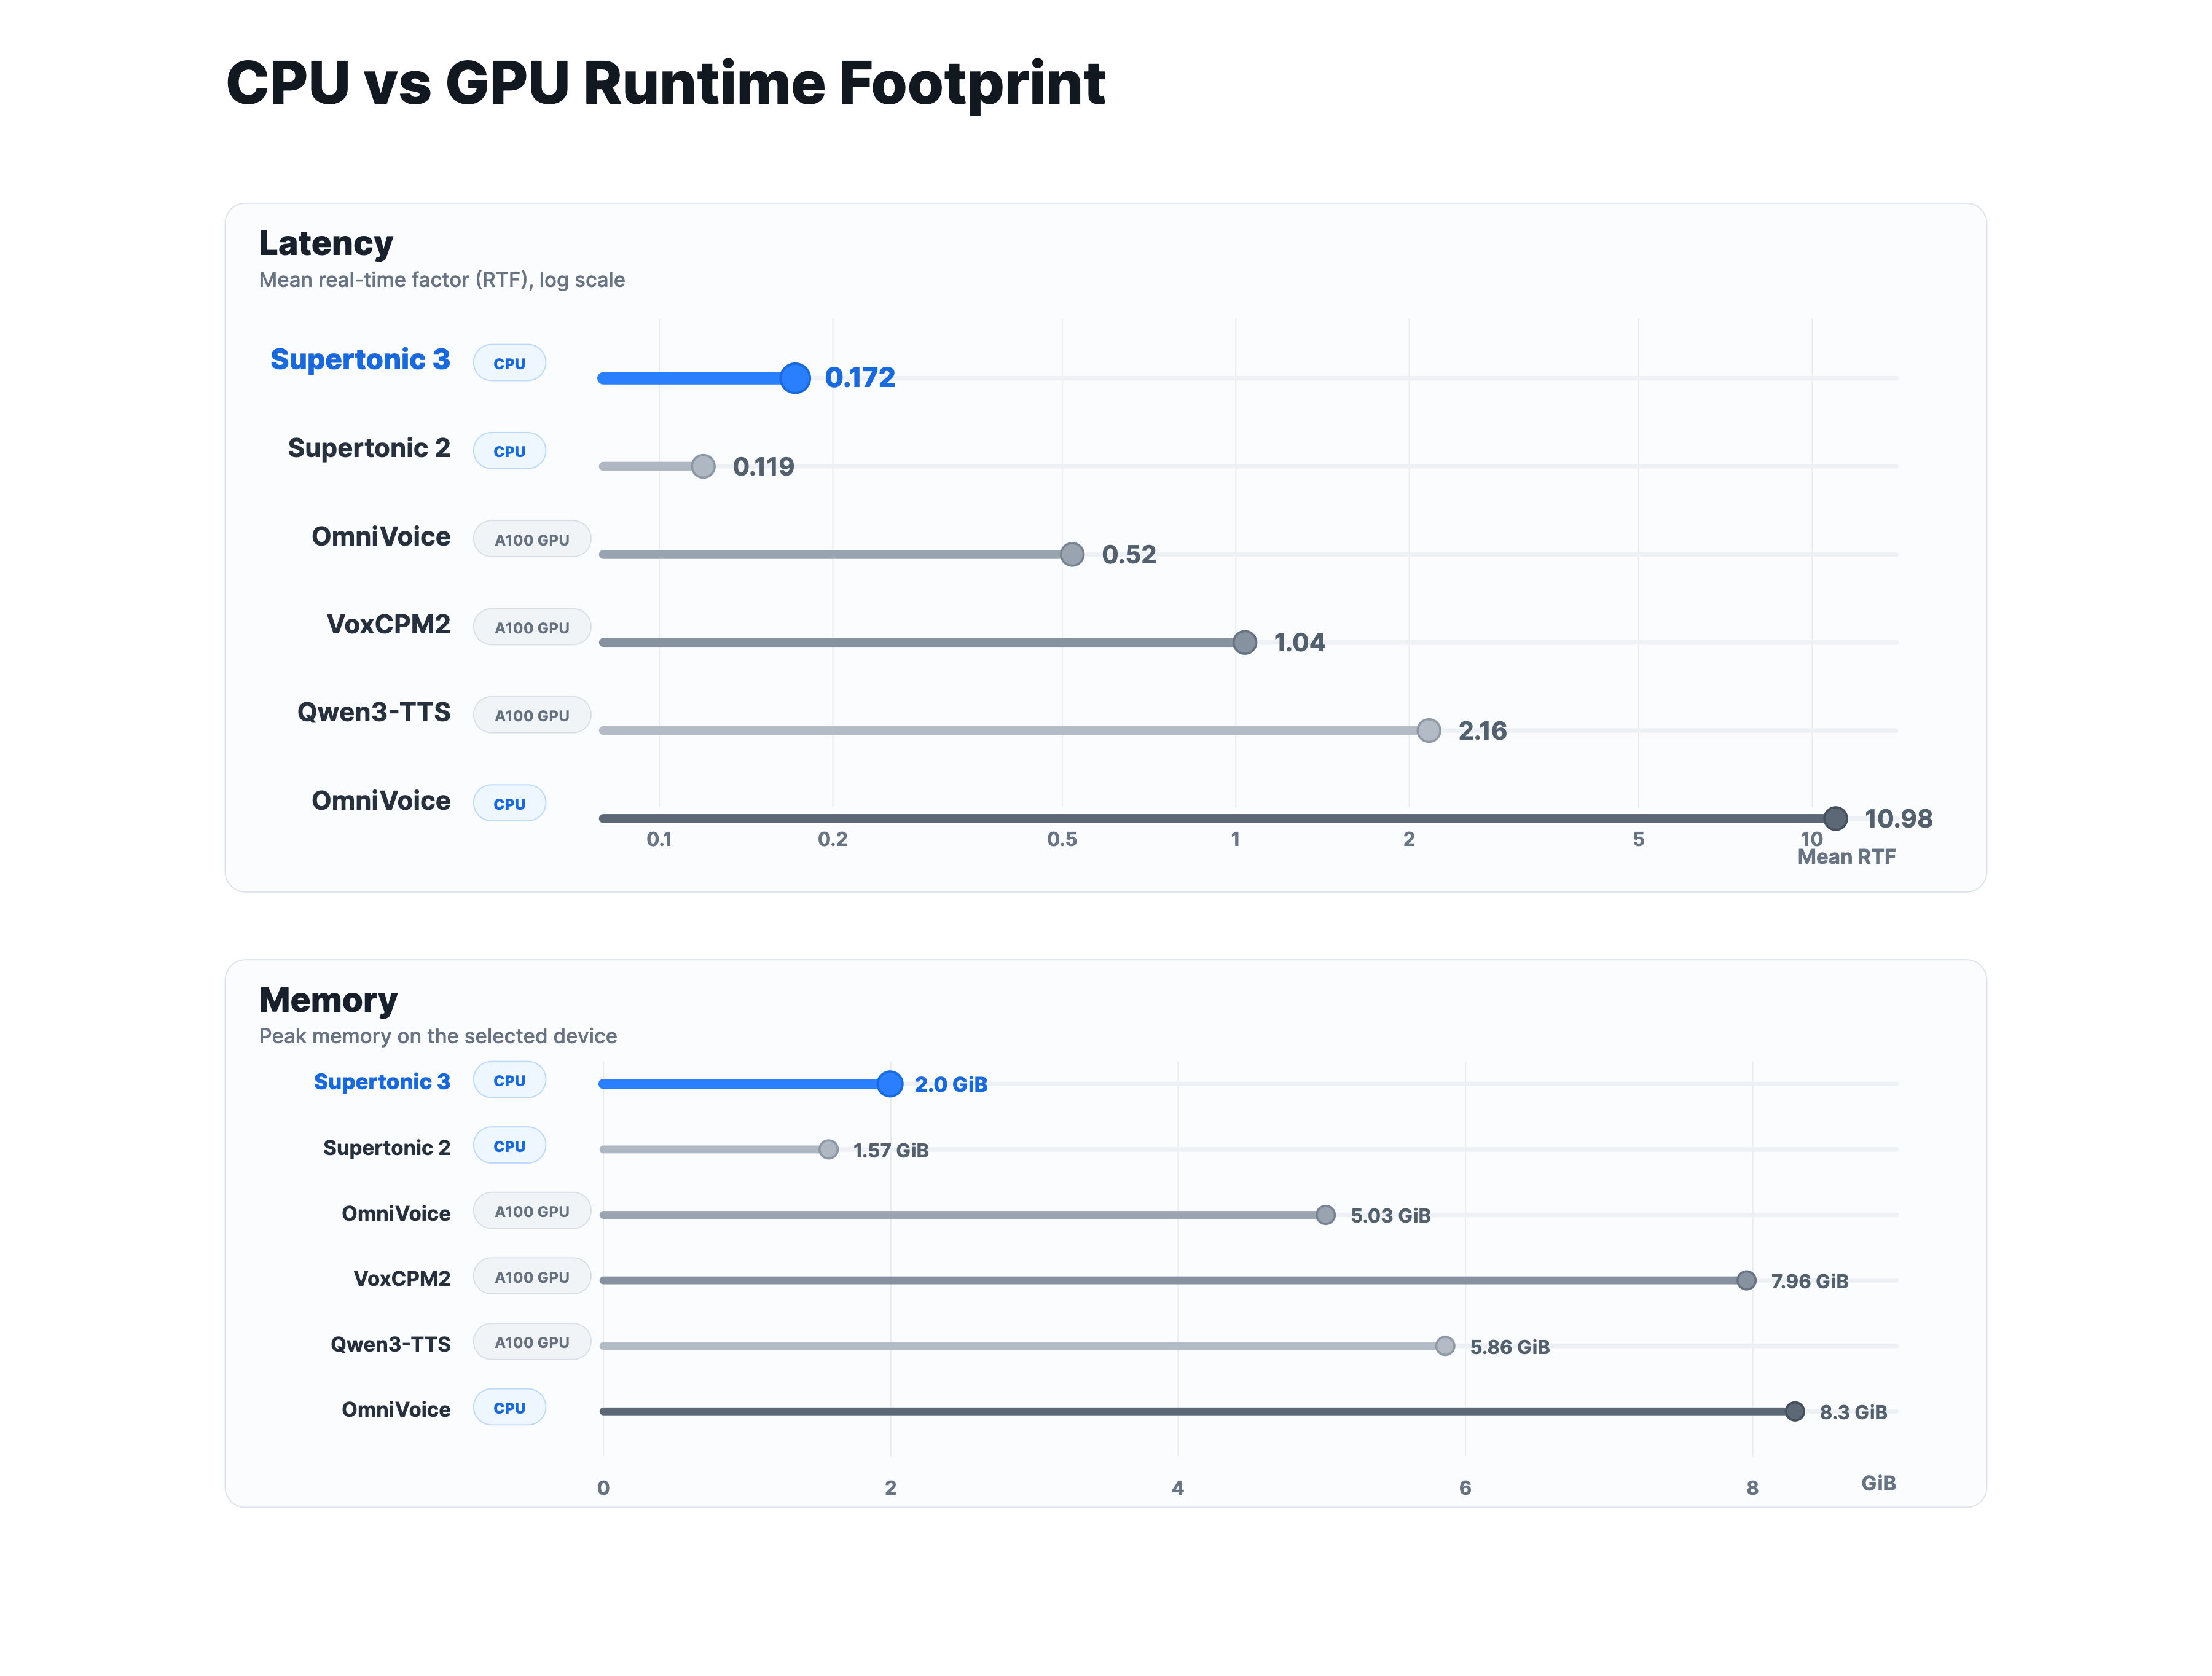
Source : graphique officiel d’empreinte d’exécution publié par Supertone, reproduit sans modification.
| Supertonic 3 | |
|---|---|
| Paramètres | Environ 99 millions |
| Précision de lecture | WER/CER compétitifs face à des modèles plus grands |
| Vitesse démontrée | RTF 0,3× sur liseuse ; temps réel sur Raspberry Pi |
| Sortie | Voix à 44,1 kHz |
| Langues | 31 |
| Licence | OpenRAIL-M |
| Rôle dans Local TTS | La voix multilingue en 31 langues |
Le face-à-face qui explique notre choix
La comparaison la plus directe vient d’un benchmark tiers indépendant qui a exécuté les deux modèles sur le même CPU modeste à 4 cœurs, sans GPU — des conditions plus proches d’un téléphone que d’un serveur d’IA. Deux résultats comptent :
- Vitesse : Supertonic 3 a synthétisé à un RTF de 0,313 avec son réglage de qualité standard — environ 3,2 fois plus vite que le temps réel — tandis que Kokoro-82M mesurait un RTF de 0,469–0,509, soit environ 2 fois le temps réel. Les deux dépassent le temps réel sur un petit CPU ; Supertonic garde la marge la plus large.
- Naturel : le même test a jugé la voix anglaise de Kokoro plus humaine, avec un rythme et une intonation naturels, tandis que les réglages les plus rapides de Supertonic sonnaient plus plats.
Autrement dit, un testeur indépendant, sans intérêt dans l’un ou l’autre modèle, est arrivé à la même conclusion que les chiffres officiels : Kokoro gagne le naturel anglais, Supertonic 3 gagne la vitesse et la couverture. S’il fallait choisir un seul modèle, il faudrait renoncer à quelque chose. Local TTS a choisi de ne pas choisir.
Pourquoi Local TTS associe les deux modèles
Dans Local TTS, les deux moteurs sont réunis derrière un seul lecteur. Chaque voix de la liste appartient à l’un des deux modèles, et quand vous choisissez une voix, l’application dirige automatiquement la synthèse vers le bon moteur — même bouton de lecture, même surlignage, mêmes réglages de vitesse, même garantie hors ligne.
L’anglais revient à Kokoro-82M
Les résultats de préférence humaine en sont la raison. Quand des auditeurs placent régulièrement un modèle de 82 millions de paramètres devant des systèmes de plusieurs milliards pour l’anglais, c’est ce modèle que méritent vos livres audio, articles et PDF en anglais. Local TTS intègre les 28 voix américaines et britanniques de Kokoro et les exécute via un pipeline Core ML optimisé pour les puces Apple, qui fournit aussi le minutage des mots derrière le surlignage mot à mot — et continue de synthétiser pendant la lecture en arrière-plan.
Tout le multilingue revient à Supertonic 3
La couverture et l’efficacité en sont la raison. Un seul modèle Supertonic 3 intégré lit le coréen, le japonais, l’allemand, le français, l’espagnol et 26 autres langues à 44,1 kHz, avec des taux d’erreur comparables à ceux de systèmes bien plus grands — et sa conception pensée pour le CPU rend la lecture en arrière-plan et les longs documents praticables sur batterie. Dix styles prédéfinis (F1–F5, M1–M5) lisent chacun les 31 langues : un document qui change de langue garde une voix cohérente.
Ce que l’association évite
- Une application limitée à l’anglais. Kokoro seul laisserait 30 langues sans voix solide.
- Une seule voix anglaise plus plate. Supertonic seul sacrifierait le naturel anglais primé en arène et le catalogue de 28 voix anglaises.
- Un recours au cloud. Les deux modèles sont assez compacts pour être intégrés : aucun texte ne quitte l’appareil pour atteindre « le meilleur modèle sur un serveur ».
Cette conception composite coûte un peu de taille d’application et de complexité technique, et nous considérons l’échange comme avantageux : les benchmarks ci-dessus en sont, en pratique, le cahier des charges.
Téléchargez gratuitement Local TTS sur l’App Store et comparez les deux moteurs sur votre propre texte — trois voix anglaises Kokoro et une voix multilingue Supertonic 3 sont gratuites.
Comment lire ces chiffres honnêtement
Les benchmarks éclairent une décision ; ils ne closent pas la discussion. Gardez quatre réserves en tête :
- Les chiffres amont n’ont pas été mesurés sur un iPhone. Classements d’arène, tableaux de WER et valeurs de RTF proviennent du matériel de leurs éditeurs. Les performances réelles dans Local TTS dépendent de votre appareil, de votre texte et de vos réglages ; le classement entre les deux modèles, lui, s’est confirmé dans tous les tests CPU indépendants que nous connaissons.
- Les classements d’arène évoluent. Le n° 1 de Kokoro est le résultat officiel de sa fenêtre d’évaluation v0.19 ; de nouveaux modèles entrent chaque mois dans les arènes. Ce que ce résultat a durablement établi, c’est qu’un modèle compact peut gagner des tests d’écoute à l’aveugle en anglais.
- Le WER/CER est noté par transcription automatique. Il mesure si les mots ont été prononcés correctement, pas si la lecture était belle — c’est justement ce que mesure l’arène humaine, et c’est pourquoi les deux métriques se lisent ensemble.
- Les réglages de vitesse sacrifient de la qualité. Les configurations les plus rapides de Supertonic réduisent le naturel. Local TTS utilise le réglage équilibré, pas celui qui fait les gros titres.
Questions fréquentes
Local TTS exécute-t-il vraiment les deux modèles sur l’appareil ?
Oui. Kokoro-82M et Supertonic 3 sont tous deux intégrés à l’application. Textes, documents et audio généré sont traités sur votre iPhone ou iPad, sans serveur vocal.
Quel modèle vais-je entendre concrètement ?
Cela dépend de la voix choisie. Les 28 voix en anglais américain et britannique sont Kokoro-82M ; les dix styles multilingues (F1–F5, M1–M5) sont Supertonic 3. Vous pouvez changer de voix pour chaque note, à tout moment.
Pourquoi ne pas utiliser les grands gagnants des benchmarks, comme VoxCPM2 ou Qwen3-TTS ?
Ces systèmes sont plusieurs fois plus grands et sont évalués sur des GPU serveur. Local TTS est construit autour de modèles qui fonctionnent hors ligne sur un téléphone ; dans cette contrainte, ces deux modèles forment la combinaison publiée la plus solide que nous connaissions.
Qui est le plus rapide, Kokoro ou Supertonic ?
Sur le même petit CPU, le test indépendant a mesuré Supertonic 3 à environ 3 fois le temps réel et Kokoro à environ 2 fois. Les deux sont largement assez rapides pour une lecture continue dans Local TTS.
Les deux moteurs sonnent-ils différemment ?
Oui, et c’est voulu. Les voix Kokoro sont des personnalités anglaises distinctes ; les styles Supertonic sont des narrateurs multilingues cohérents. Préécoutez quelques voix sur votre propre texte — la version gratuite inclut les deux moteurs.
Tout cela nécessite-t-il une connexion Internet ?
Non. Les deux modèles génèrent la voix hors ligne. Le mode avion est un excellent moyen de le vérifier.
Écoutez les benchmarks par vous-même
Les chiffres expliquent une conception ; vos oreilles la confirment. Collez un article en anglais et écoutez une voix Kokoro, puis collez un paragraphe en français, en coréen ou en allemand et laissez Supertonic 3 prendre le relais — même application, même confidentialité, aucun cloud entre les deux.
Téléchargez gratuitement Local TTS sur l’App Store et écoutez pourquoi nous utilisons deux modèles plutôt qu’un.
Pour aller plus loin sur chaque moteur, lisez notre guide de Kokoro-82M et notre guide de Supertonic 3.
Chaque texte devient une voix — hors ligne
Local TTS lit les PDF, e-books et articles à voix haute directement sur votre iPhone — en privé, naturellement.
Télécharger sur l'App Store