
Índice
- A resposta em uma frase
- Como se mede o desempenho de texto em voz
- O que os benchmarks dizem sobre o Kokoro-82M
- O que os benchmarks dizem sobre o Supertonic 3
- O confronto direto que explica nossa decisão
- Por que o Local TTS une os dois modelos
- Como ler estes números com honestidade
- Perguntas frequentes
- Ouça os benchmarks com os próprios ouvidos
O Local TTS vem com dois modelos neurais de voz em vez de um. O Kokoro-82M cuida das vozes de inglês americano e britânico, e o Supertonic 3, da voz multilíngue que lê 31 idiomas. Os dois rodam inteiramente no seu iPhone ou iPad.
Por que carregar dois modelos, se um só deixaria o aplicativo menor e mais simples? Porque os benchmarks publicados dão uma resposta clara: hoje, nenhum modelo compacto para dispositivo vence ao mesmo tempo em naturalidade, precisão de leitura, velocidade e cobertura de idiomas. Cada um desses dois vence uma corrida diferente, e combiná-los permite ao Local TTS usar cada modelo exatamente onde ele é mais forte.
Este artigo percorre os resultados oficiais de avaliação por trás dessa decisão: o que os criadores dos modelos mediram, o que testes independentes encontraram e como tudo isso se traduz no leitor que você realmente ouve.
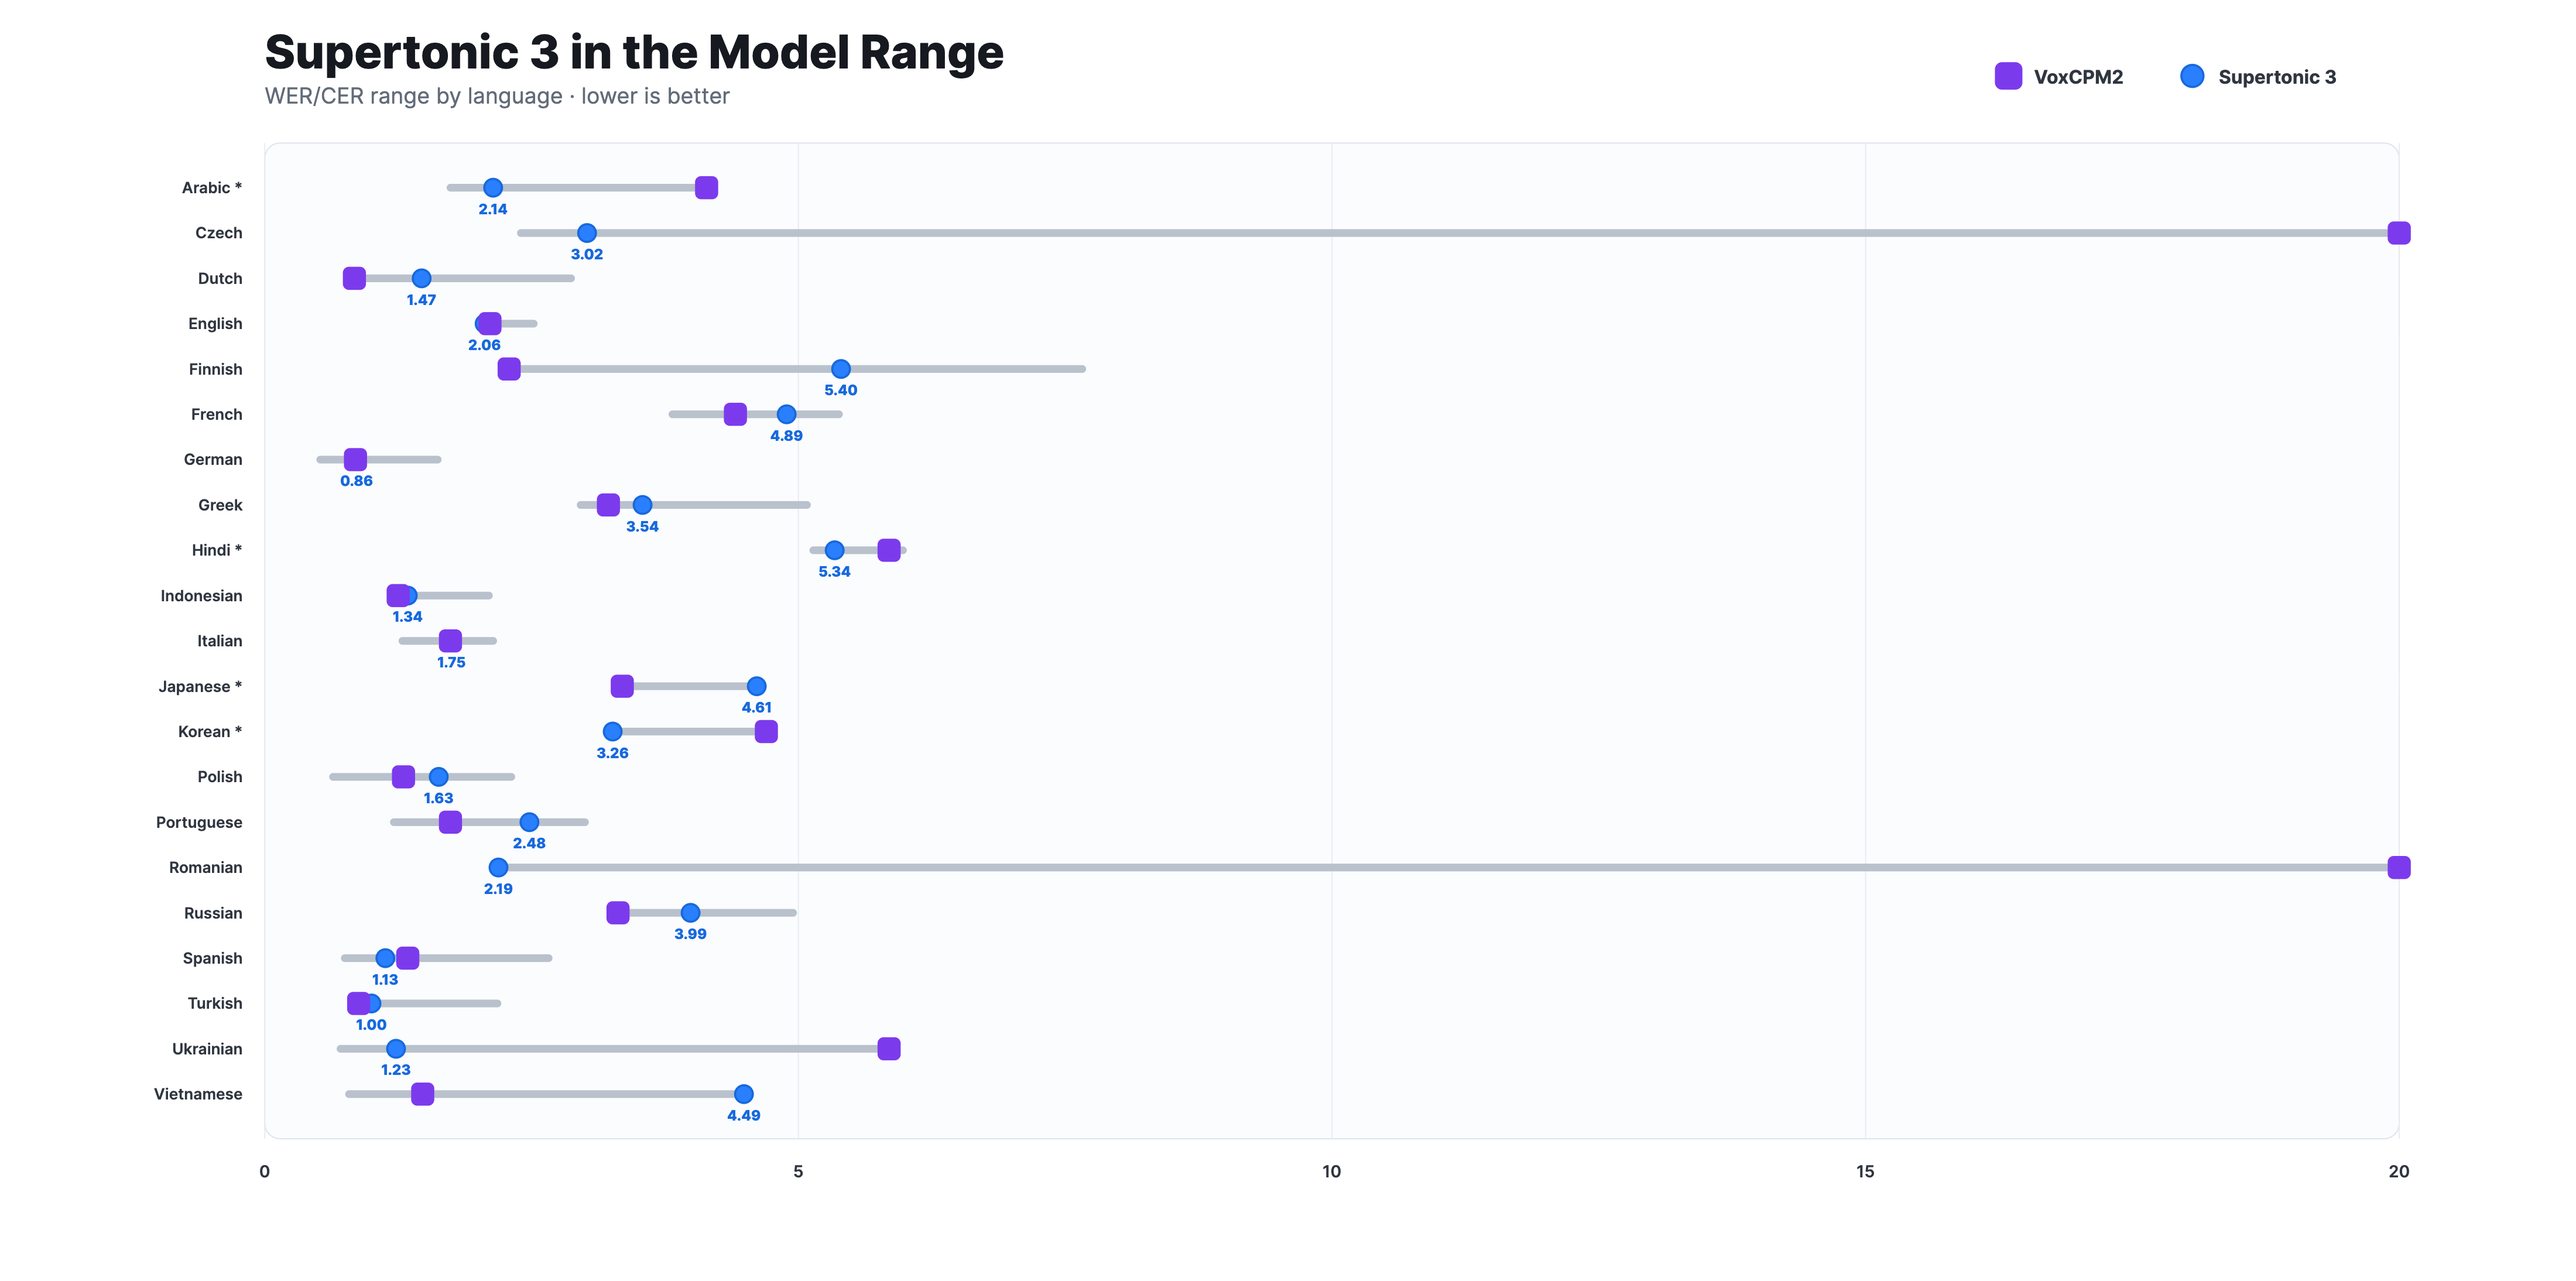
Fontes e imagem de capa: A capa é o gráfico oficial de precisão de leitura da Supertone, reproduzido sem alterações a partir do repositório do Supertonic. Os números do Kokoro vêm do card oficial hexgrad/Kokoro-82M; os do Supertonic, do repositório oficial da Supertone e do card do modelo; o teste direto em CPU, de um benchmark independente de terceiros. Os números originais foram medidos por quem os publicou, no hardware deles, não em um iPhone.
A resposta em uma frase
O Kokoro-82M lidera as avaliações humanas de naturalidade em inglês; o Supertonic 3 lidera em velocidade na CPU e lê 31 idiomas com precisão competitiva. Por isso o Local TTS envia o inglês para o Kokoro e tudo que é multilíngue para o Supertonic 3 — sempre no seu aparelho.
Como se mede o desempenho de texto em voz
Quatro medições importam para um aplicativo de leitura, e vale saber o que cada uma significa antes de olhar os números:
- Naturalidade é julgada por pessoas. O teste público mais conhecido é uma arena às cegas: os ouvintes escutam dois áudios anônimos e votam no que soa mais natural, gerando um ranking no estilo Elo que o marketing não consegue influenciar.
- Precisão de leitura pergunta se o modelo falou exatamente o texto recebido, sem palavras puladas, repetidas ou embaralhadas. Ela é medida como taxa de erro por palavra (WER) ou por caractere (CER), transcrevendo de volta o áudio gerado. Quanto menor, melhor.
- Velocidade é informada como fator de tempo real (RTF): o tempo de síntese dividido pela duração do áudio. Um RTF de 0,3 significa que um segundo de fala leva 0,3 segundo para ser gerado — cerca de 3,3× mais rápido que o tempo real. Quanto menor, mais rápido.
- Consumo de recursos cobre parâmetros, tamanho do download e memória — a diferença entre um modelo que cabe em um app de celular e um que precisa de GPU de servidor.
Uma voz na nuvem pode perseguir as quatro com hardware de data center. Um modelo no dispositivo precisa fazer escolhas, e é aí que os dois modelos seguem caminhos opostos.
O que os benchmarks dizem sobre o Kokoro-82M
O resultado mais famoso do Kokoro-82M é um ranking de preferência humana. Antes do lançamento da v1.0, o card oficial registrou que o Kokoro v0.19 ficou em 1º lugar na TTS Spaces Arena, a arena de audição às cegas do Hugging Face — com um Elo acima do de modelos muitas vezes maiores, como o XTTS v2 (467 milhões de parâmetros) e o MetaVoice (1,2 bilhão de parâmetros), tendo sido treinado com apenas algumas centenas de horas de áudio.
É um resultado incomum, que merece uma pausa. Em um teste no qual os ouvintes não viam nomes de modelo nem contagens de parâmetros, um modelo de 82 milhões de parâmetros foi preferido a sistemas de bilhões. Em naturalidade em inglês por unidade de processamento, o Kokoro definiu o padrão dos modelos compactos.
| Kokoro-82M v1.0 | |
|---|---|
| Parâmetros | 82 milhões |
| Avaliação humana | v0.19 em 1º lugar na TTS Spaces Arena |
| Saída | Voz em 24 kHz |
| Vozes | 54 vozes públicas; 28 em inglês no Local TTS |
| Licença | Apache 2.0 |
| Função no Local TTS | Catálogo de inglês americano e britânico |
O preço é a cobertura. A versão pública do Kokoro abrange oito idiomas, mas o próprio catálogo de vozes avisa que a qualidade fora do inglês varia conforme os dados de treinamento. Ele é um especialista: excepcional em inglês, limitado no resto.
O que os benchmarks dizem sobre o Supertonic 3
O Supertonic 3, lançado pela Supertone em 29 de abril de 2026, é avaliado na direção oposta: amplitude e eficiência. O repositório oficial publica resultados de precisão de leitura no benchmark Minimax-MLS-test, comparando seu modelo de cerca de 99 milhões de parâmetros com sistemas TTS abertos bem maiores, como VoxCPM2, OmniVoice e Qwen3-TTS.
Estas são as taxas de erro publicadas pela Supertone para os onze idiomas em que este site é escrito (quanto menor, melhor; * indica taxa de erro por caractere; as demais são por palavra):
| Idioma | VoxCPM2 | OmniVoice | Qwen3-TTS | Supertonic 3 |
|---|---|---|---|---|
| Inglês | 2,11 | 2,02 | 2,25 | 2,06 |
| Coreano* | 4,70 | 3,22 | 4,07 | 3,26 |
| Japonês* | 3,35 | 3,81 | 3,67 | 4,61 |
| Alemão | 0,85 | 0,96 | 0,52 | 0,86 |
| Francês | 4,41 | 4,74 | 3,82 | 4,89 |
| Espanhol | 1,34 | 0,99 | 0,75 | 1,13 |
| Português | 1,74 | 1,40 | 1,21 | 2,48 |
| Italiano | 1,74 | 1,29 | 1,40 | 1,75 |
| Neerlandês | 0,84 | 0,77 | — | 1,47 |
| Polonês | 1,30 | 0,64 | — | 1,63 |
| Turco | 0,88 | 2,18 | — | 1,00 |
O Supertonic 3 não vence em todas as linhas, e a Supertone não afirma que vença. A conclusão oficial é mais útil: ele permanece dentro da faixa de erro competitiva de modelos várias vezes maiores, em 31 idiomas, e continua pequeno o bastante para rodar sem nenhuma GPU.
A velocidade é onde seus números se destacam. A Supertone demonstra o Supertonic 3 rodando em hardware bem mais fraco que um iPhone atual: um leitor de e-books Onyx Boox Go 6 em modo avião, com RTF médio de 0,3× — cerca de três vezes mais rápido que o tempo real em um e-reader — e síntese em tempo real em um Raspberry Pi. O comparativo oficial de execução mostra o modelo rodando rápido em CPUs comuns, mesmo diante de sistemas maiores medidos em uma GPU de servidor NVIDIA A100, e usando bem menos memória.
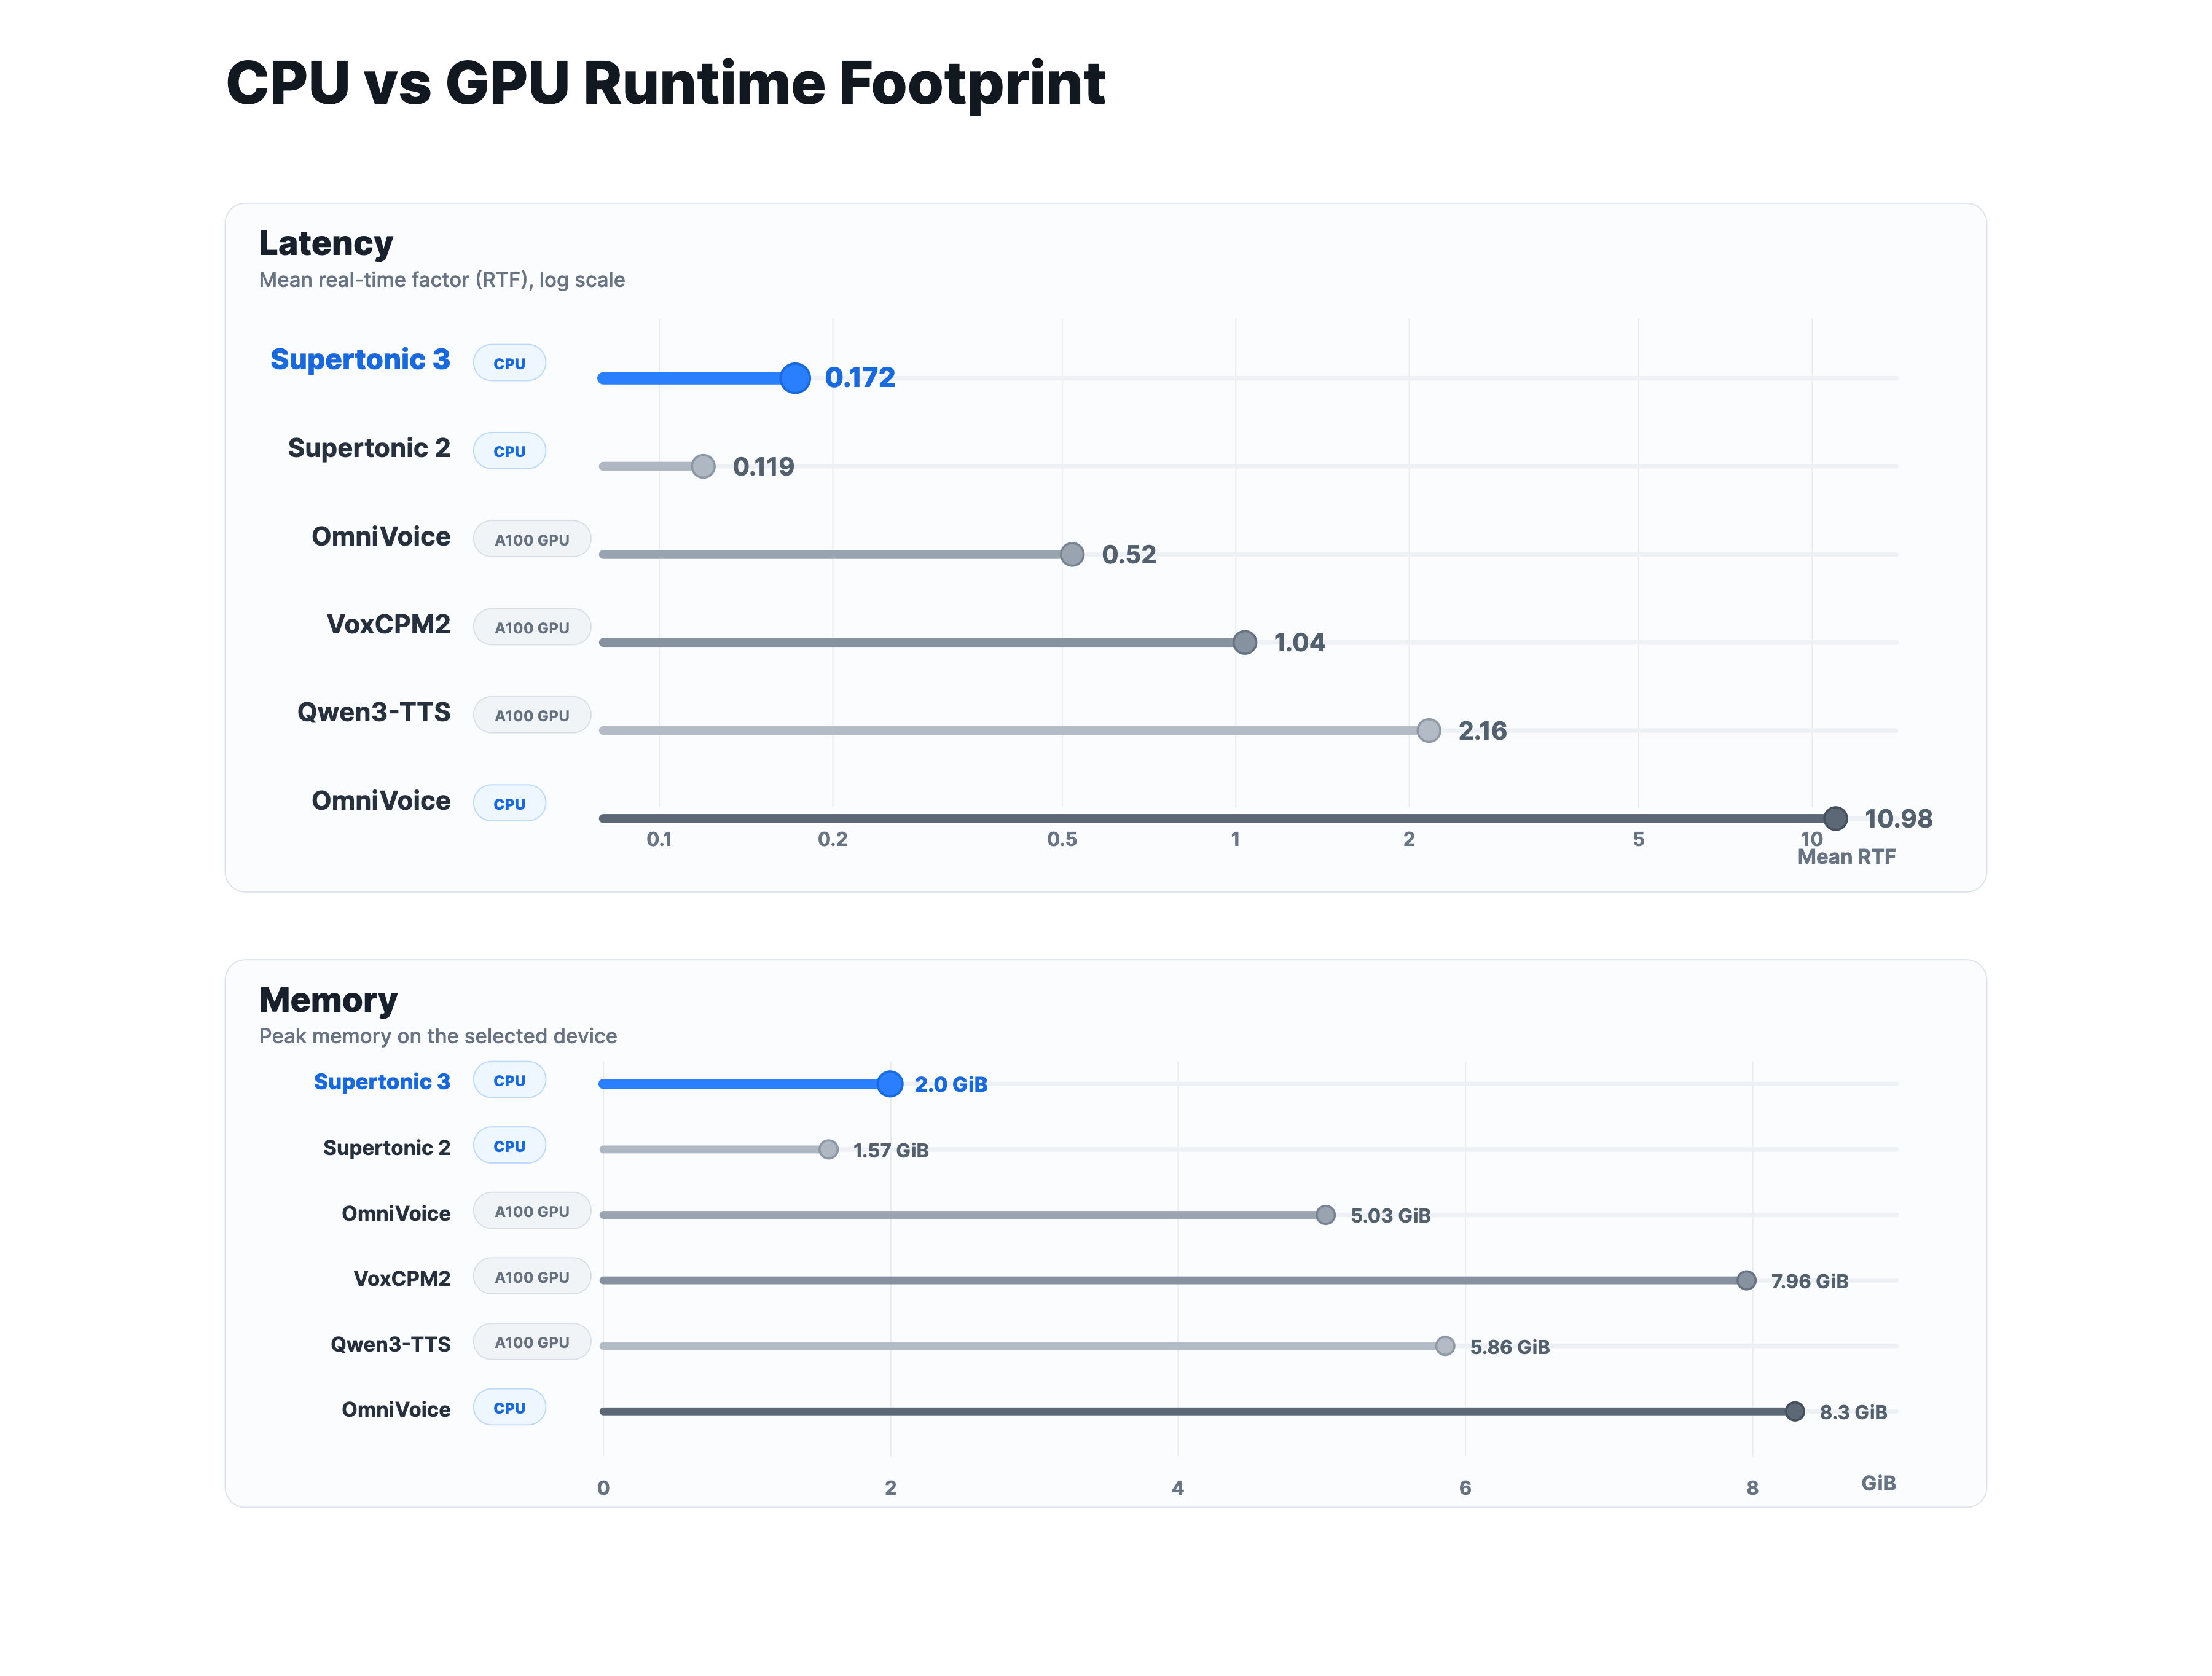
Fonte: gráfico oficial de execução e memória da Supertone, reproduzido sem alterações.
| Supertonic 3 | |
|---|---|
| Parâmetros | Cerca de 99 milhões |
| Precisão de leitura | WER/CER competitivos frente a modelos muito maiores |
| Velocidade demonstrada | RTF 0,3× em um e-reader; tempo real no Raspberry Pi |
| Saída | Voz em 44,1 kHz |
| Idiomas | 31 |
| Licença | OpenRAIL-M |
| Função no Local TTS | A voz multilíngue de 31 idiomas |
O confronto direto que explica nossa decisão
A comparação mais direta vem de um benchmark independente de terceiros que rodou os dois modelos na mesma CPU modesta de 4 núcleos, sem GPU — condições mais próximas de um celular do que de um servidor de IA. Dois resultados importam:
- Velocidade: o Supertonic 3 sintetizou com RTF de 0,313 no ajuste de qualidade padrão — cerca de 3,2× mais rápido que o tempo real —, enquanto o Kokoro-82M marcou RTF de 0,469–0,509, cerca de 2× o tempo real. Os dois superam o tempo real em uma CPU pequena; o Supertonic tem a margem maior.
- Naturalidade: o mesmo teste considerou o inglês do Kokoro o mais humano, com prosódia natural, enquanto os ajustes mais rápidos do Supertonic soaram mais monótonos.
Em outras palavras, um avaliador independente, sem interesse em nenhum dos dois modelos, chegou à mesma conclusão que os números oficiais apontam: o Kokoro vence em naturalidade em inglês; o Supertonic 3 vence em velocidade e amplitude. Quem escolhesse um único modelo teria que abrir mão de algo. O Local TTS decidiu não escolher.
Por que o Local TTS une os dois modelos
Dentro do Local TTS, os dois mecanismos ficam atrás de um único leitor. Cada voz da lista pertence a um dos dois modelos e, quando você escolhe uma voz, o app direciona a síntese ao mecanismo certo automaticamente — mesmo botão de reproduzir, mesmo destaque, mesmos controles de velocidade, mesma garantia offline.
O inglês vai para o Kokoro-82M
O motivo são os resultados de preferência humana. Quando os ouvintes votam de forma consistente em um modelo de 82M acima de sistemas de bilhões de parâmetros para o inglês, é esse modelo que seus audiolivros, artigos e PDFs em inglês merecem. O Local TTS inclui as 28 vozes americanas e britânicas do Kokoro e as executa em um pipeline Core ML ajustado para o Apple Silicon, que também fornece a marcação de tempo por trás do destaque palavra por palavra — e continua sintetizando durante a reprodução em segundo plano.
Tudo que é multilíngue vai para o Supertonic 3
O motivo são a cobertura e a eficiência. Um único modelo Supertonic 3 incluído lê coreano, japonês, alemão, francês, espanhol e mais 26 idiomas em 44,1 kHz, com taxas de erro competitivas frente a sistemas bem maiores — e seu design voltado à CPU mantém viáveis, mesmo na bateria, a leitura em segundo plano e os documentos longos. Cada um dos dez estilos predefinidos (F1–F5, M1–M5) lê os 31 idiomas, então um documento que muda de língua mantém a mesma voz do início ao fim.
O que a combinação evita
- Um app só de inglês. O Kokoro sozinho deixaria 30 idiomas sem uma voz forte.
- Uma única voz de inglês mais monótona. O Supertonic sozinho abriria mão da naturalidade em inglês vencedora da arena e do catálogo de 28 vozes.
- Um plano B na nuvem. Os dois modelos são pequenos o bastante para vir dentro do app, então nenhum texto sai do aparelho em busca do “modelo melhor em um servidor”.
O design combinado custa algum tamanho de app e complexidade de engenharia, e consideramos a troca boa: os benchmarks acima são, na prática, a especificação dessa escolha.
Baixe o Local TTS grátis na App Store e compare os dois mecanismos com o seu próprio texto — três vozes Kokoro em inglês e uma voz multilíngue Supertonic 3 são gratuitas.
Como ler estes números com honestidade
Benchmarks orientam uma decisão; não encerram a conversa. Guarde quatro ressalvas:
- Os números originais não foram medidos em um iPhone. Rankings de arena, tabelas de WER e valores de RTF vêm do hardware de quem os publicou. O desempenho do Local TTS depende do seu aparelho, do texto e dos ajustes; a ordem entre os modelos, porém, se manteve em todos os testes independentes de CPU que encontramos.
- Rankings de arena mudam. O 1º lugar do Kokoro é o registro oficial da janela de avaliação da v0.19; modelos novos entram nas arenas todo mês. O que o resultado estabeleceu de forma duradoura é que modelos compactos podem vencer testes cegos de audição em inglês.
- WER/CER é medido por transcrição automática. Ele verifica se as palavras foram ditas corretamente, não se a leitura ficou bonita — isso é o que a arena humana mede, e é por isso que vale ler as duas métricas juntas.
- Ajustes de velocidade sacrificam qualidade. As configurações mais velozes do Supertonic reduzem a naturalidade. O Local TTS usa o ajuste equilibrado, não o que rende manchete.
Perguntas frequentes
O Local TTS roda mesmo os dois modelos no aparelho?
Sim. O Kokoro-82M e o Supertonic 3 vêm incluídos no aplicativo. Texto, documentos e o áudio gerado são processados no seu iPhone ou iPad, sem servidor de voz.
Qual modelo eu vou ouvir na prática?
Depende da voz escolhida. As 28 vozes de inglês americano e britânico são o Kokoro-82M; os dez estilos multilíngues (F1–F5, M1–M5) são o Supertonic 3. Você pode trocar a cada nota, quando quiser.
Por que não usar logo os maiores vencedores dos benchmarks, como VoxCPM2 ou Qwen3-TTS?
Esses sistemas são várias vezes maiores e são avaliados em GPUs de servidor. O Local TTS é construído em torno de modelos que rodam offline em um celular; dentro dessa restrição, esses dois formam a combinação publicada mais forte que conhecemos.
Quem é mais rápido: o Kokoro ou o Supertonic?
Na mesma CPU pequena, o teste independente mediu o Supertonic 3 em cerca de 3× o tempo real e o Kokoro em cerca de 2×. Os dois são rápidos o suficiente para a leitura contínua no Local TTS.
Os dois mecanismos soam diferente?
Sim, de propósito. As vozes Kokoro são personalidades individuais em inglês; os estilos Supertonic são narradores multilíngues consistentes. Experimente algumas vozes com o seu próprio texto — a versão gratuita inclui os dois mecanismos.
Algo disso exige conexão com a internet?
Não. Os dois modelos geram a voz offline. O modo avião é um ótimo lugar para comprovar.
Ouça os benchmarks com os próprios ouvidos
Números explicam um design; seus ouvidos o confirmam. Cole um artigo em inglês e ouça uma voz Kokoro; depois cole um parágrafo em português, coreano ou alemão e ouça o Supertonic 3 assumir — mesmo app, mesma privacidade, nenhuma nuvem no caminho.
Baixe o Local TTS grátis na App Store e ouça por que rodamos dois modelos em vez de um.
Para conhecer cada mecanismo a fundo, leia nosso guia do Kokoro-82M e o guia do Supertonic 3.
Qualquer texto vira voz — offline
O Local TTS lê PDFs, e-books e artigos em voz alta direto no seu iPhone — em particular e com naturalidade.
Baixar na App Store